Allergen Labels
Kennzeichnet die 14 EU-Allergene in jedem Gericht in vier Sprachen und druckt nichts, bevor ein Koch es bestätigt hat.
- Rolle
- Eigenes Projekt — Konzept, Code, Tests
- Jahr
- 2026
- Kategorie
- KI · Web
- Technologien
- Python 3.12, FastAPI, Jinja2, SQLite
Das Problem
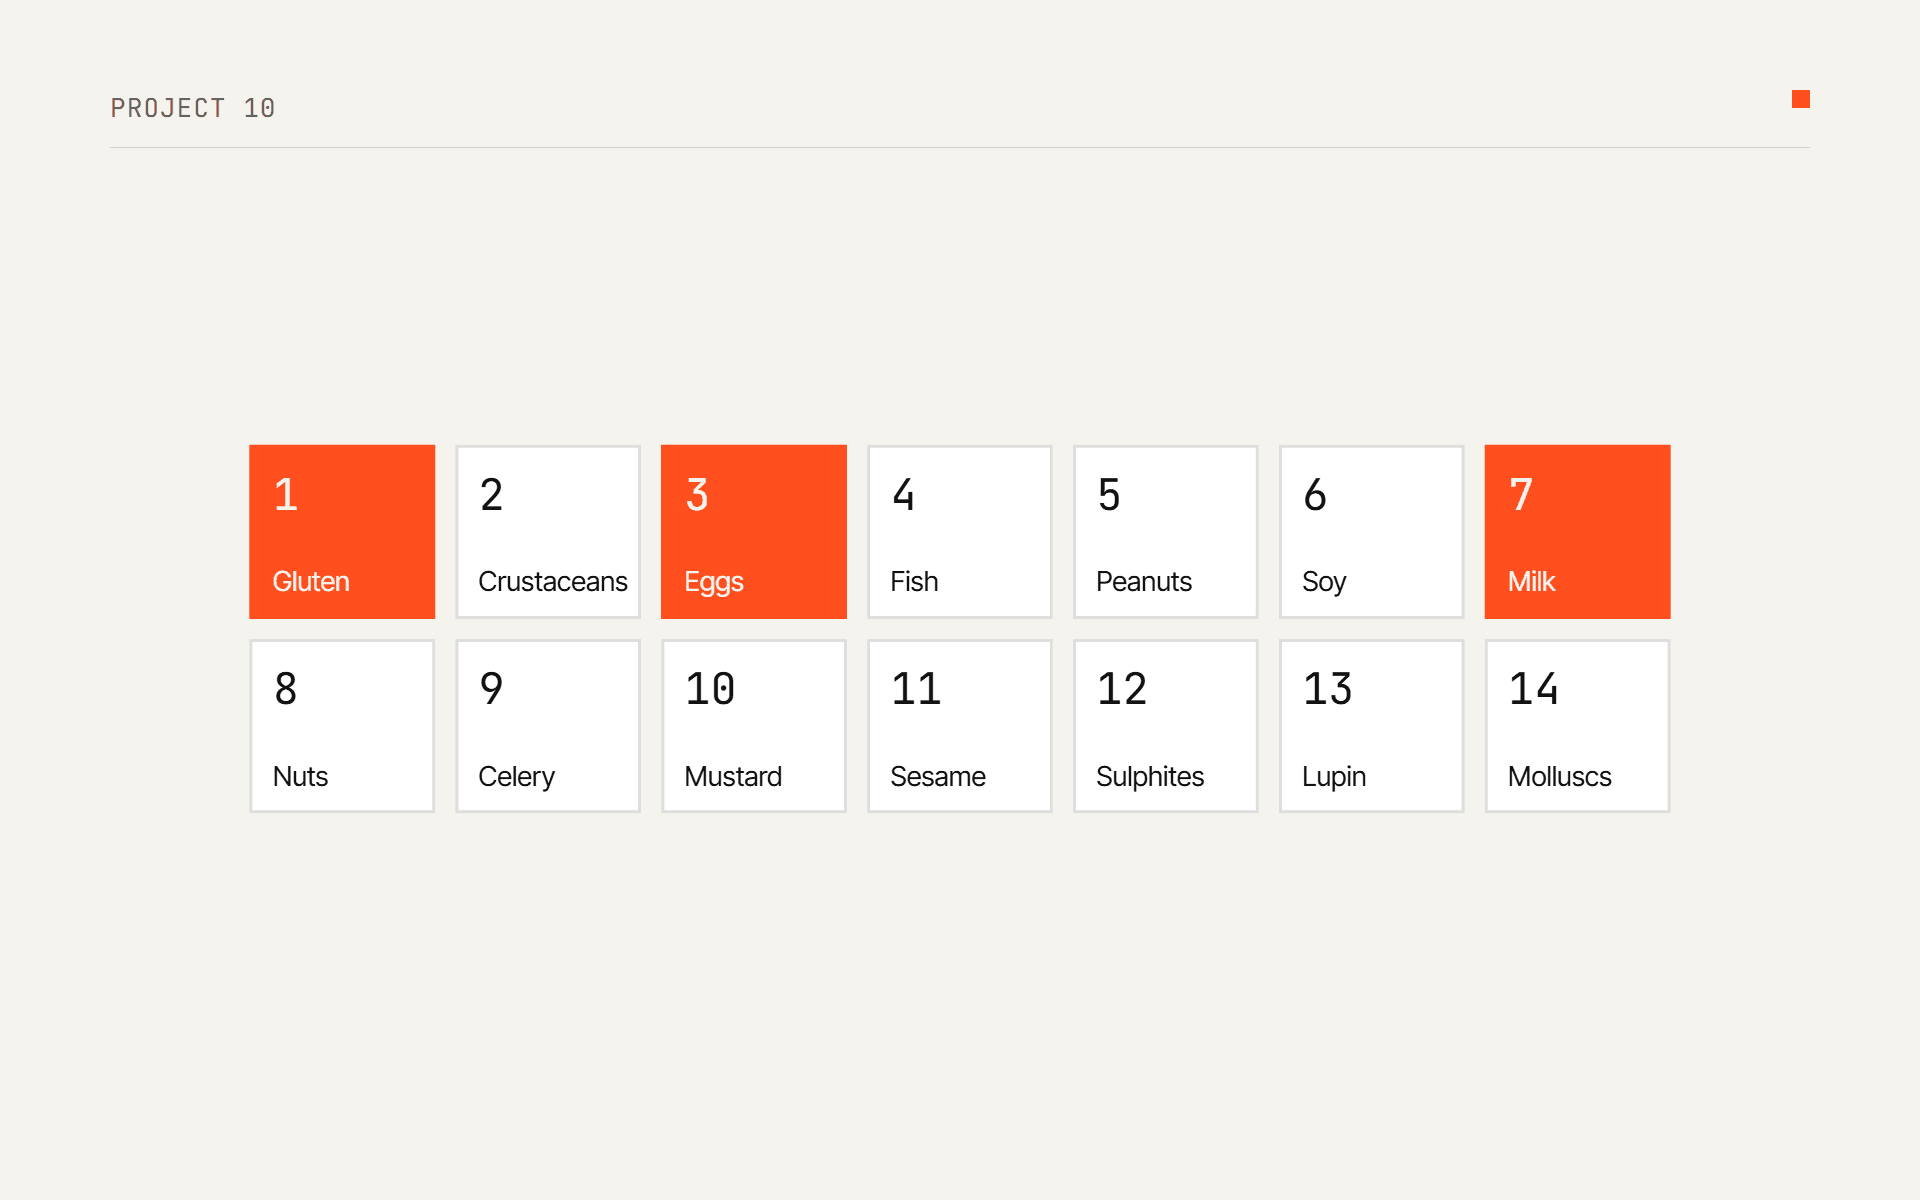
Das EU-Lebensmittelrecht (Verordnung 1169/2011, Artikel 9 Absatz 1 Buchstabe c und Anhang II) verlangt die Angabe von 14 Allergengruppen, und Artikel 44 macht sie für unverpackt abgegebene Lebensmittel verpflichtend, also auch für Restaurants und Hotelküchen. Wie die Angabe aussieht, regelt jedes Land selbst.
Schwierig ist nicht die Liste. Küchen ändern ständig ihre Rezepte: der Brühwürfel eines neuen Lieferanten, Cashews statt Pinienkernen im Pesto, Butter in einer Soße, die früher mit Öl gemacht wurde. Die Allergennummern auf der Karte werden einmal geschrieben und veralten. In Antalya lesen Touristen dieselbe Karte in verschiedenen Sprachen, und ein Gast mit Nussallergie muss einer Zahl neben dem Gericht vertrauen.
Die Lösung
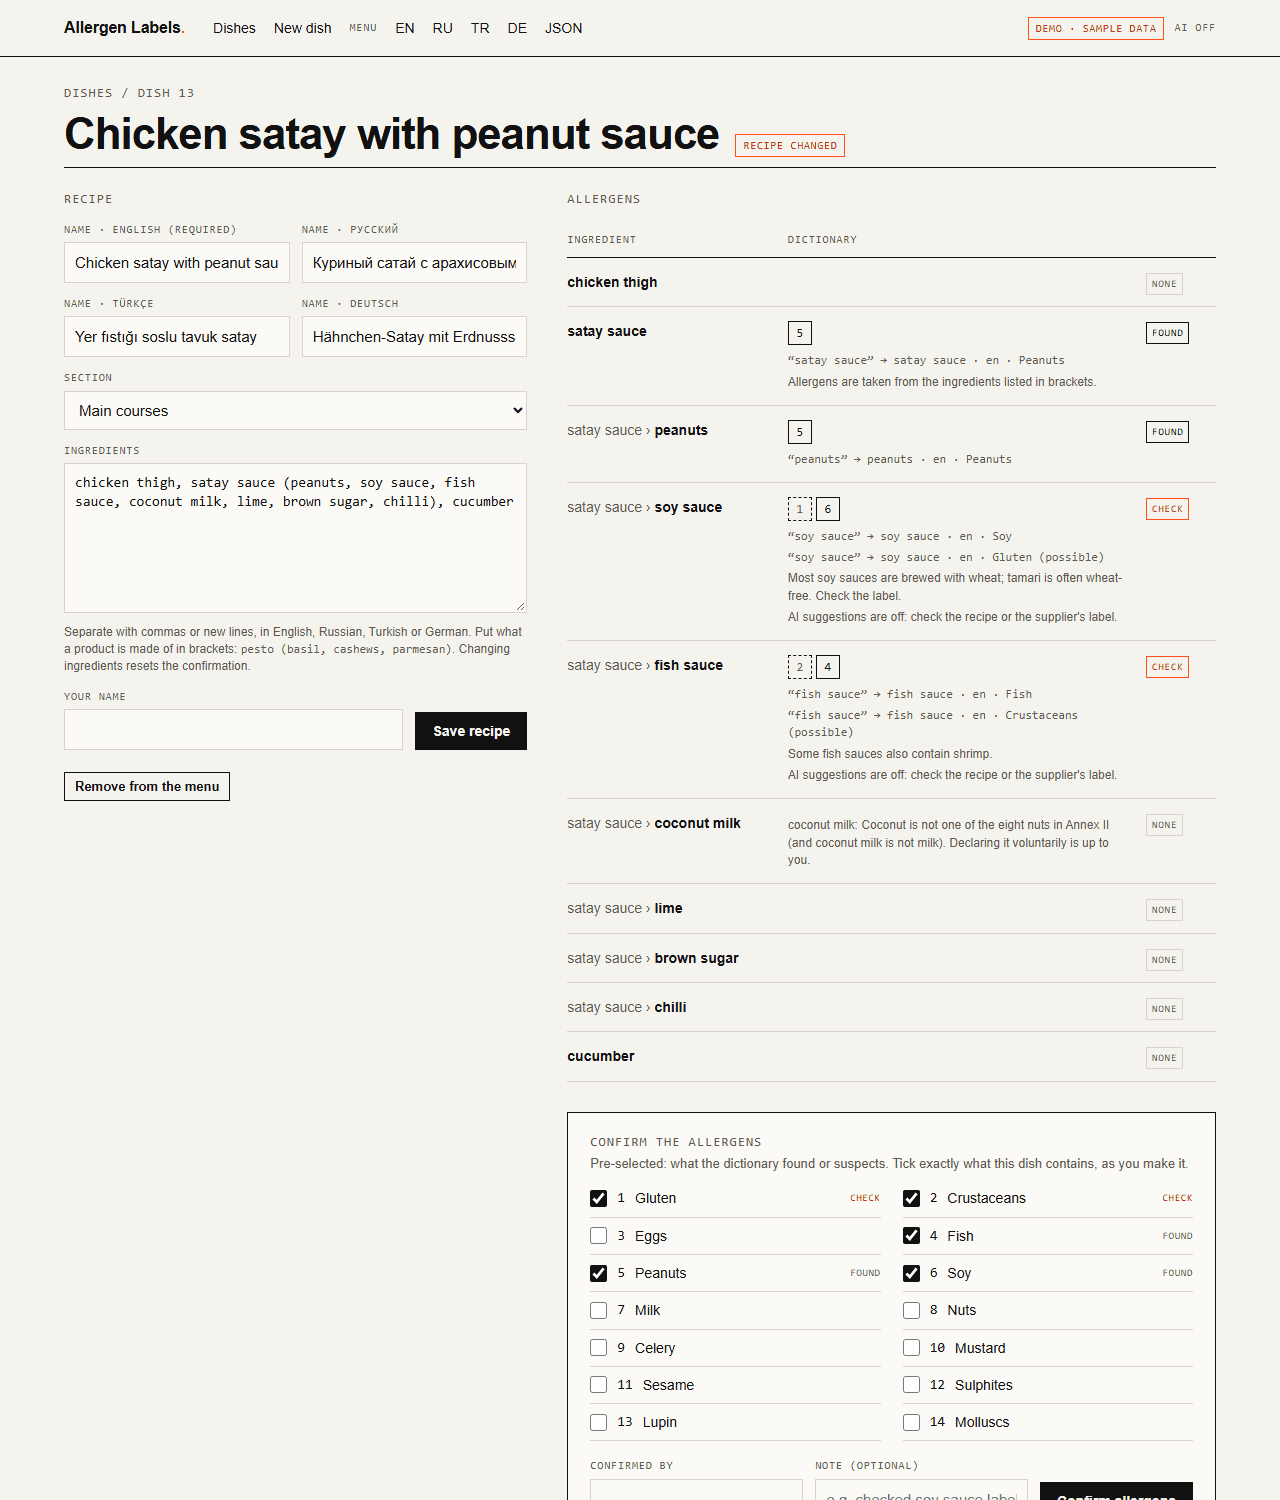
- Der Koch gibt die Zutaten so ein, wie die Küche sie schreibt: auf Englisch, Russisch, Türkisch oder Deutsch. Ein kuratiertes Wörterbuch mit 2.429 Einträgen findet die Allergene und zeigt bei jedem Treffer das Wort, aus dem er stammt.
- Es versteht Pluralformen, russische Fälle („сметаной"), türkische Suffixe („fındığı", „peynirli") und deutsche Komposita („Haselnusskrokant"), mit und ohne Umlaute.
- Zusammengesetzte Produkte haben typische Allergene: „Sojasoße" ist Soja und möglicherweise Gluten, „Pesto" möglicherweise Milch und Schalenfrüchte. Wer
pesto (basil, cashews, parmesan)schreibt, ersetzt die Vermutung durch die echten Bestandteile. - Was wie ein Allergen aussieht, aber nicht in Anhang II steht, wird erklärt statt markiert: Kokos, Pinienkerne, Muskatnuss, Buchweizen, Glukosesirup. „Laktosefreie Milch" bleibt Milch.
- Unbekannte oder mehrdeutige Wörter („fıstık" ist Erdnuss oder Pistazie, „масло" ist Butter oder Öl) werden für einen Menschen markiert. Mit API-Schlüssel schlägt Claude Gruppen mit kurzer Begründung vor, gekennzeichnet als „muss bestätigt werden"; ohne Schlüssel werden sie nur markiert.
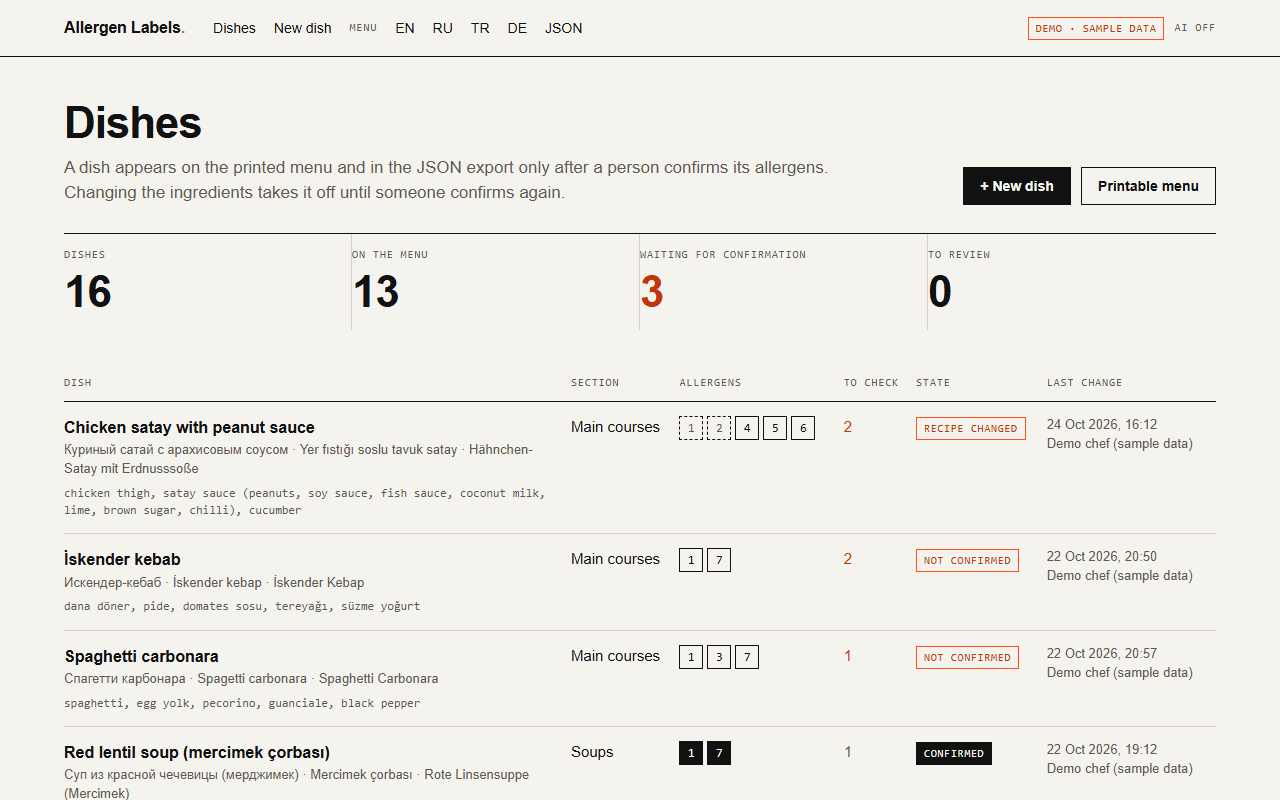
- Nichts wird veröffentlicht, bevor ein Mensch das Gericht mit seinem Namen bestätigt. Jede Bestätigung wird protokolliert; eine Änderung der Zutaten setzt sie zurück; eine Seite, die geöffnet wurde, bevor jemand anderes das Rezept geändert hat, kann es nicht bestätigen.
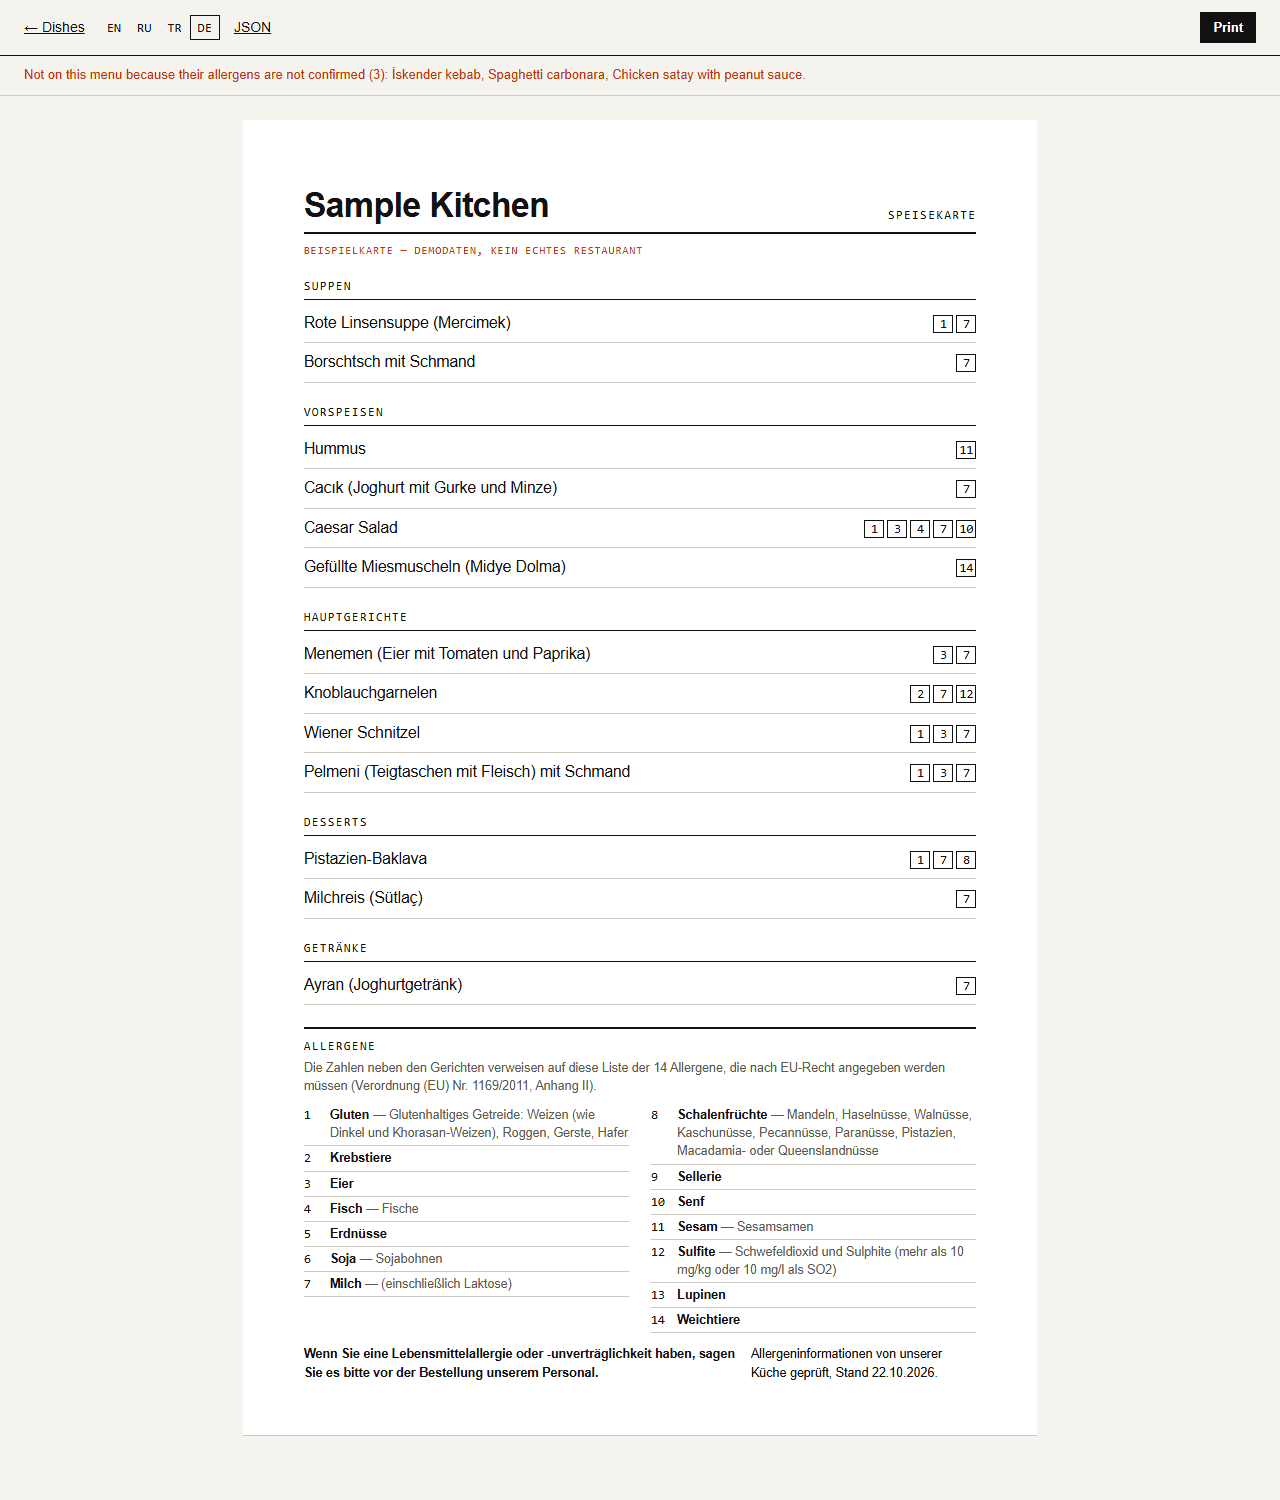
- Druckbare Speisekarte in vier Sprachen mit Allergennummern und Legende, dazu ein JSON-Export.
Screenshots
Technologien
- Python 3.12
- FastAPI
- Jinja2
- SQLite
- Anthropic API
- pytest
- Docker
Die Hauptarbeit macht das Wörterbuch, und es funktioniert offline. Das LLM sieht nur die Zutaten, die das Wörterbuch nicht klären konnte; seine Antwort folgt einem JSON-Schema, dessen Allergenfeld ein Enum der 14 Gruppen-IDs ist, und sie setzt nur Häkchen im Bestätigungsformular vor. SQLite-Trigger machen das Bestätigungsprotokoll unveränderlich: Einträge können nur hinzugefügt werden. Die Weboberfläche besteht aus einfachen HTML-Formularen und braucht kein JavaScript.
Code im Detail
Jeder Wörterbucheintrag wird zu einem regulären Ausdruck über einen „gefalteten" Text (Kleinbuchstaben, ohne diakritische Zeichen, türkisches „İ/ı" vereinheitlicht). Jede Sprache bekommt ihre eigenen Wortformen:
def _word(word: str, language: Language, last: bool, exact: bool) -> str:
    escaped = re.escape(word)
    if exact:
        return escaped
    if language is Language.EN:
        if not last:
            return escaped
        if len(word) > 2 and word.endswith("y") and word[-2] not in _VOWELS:
            return re.escape(word[:-1]) + "(?:y|ies)"
        return escaped + "(?:s|es)?"
    if language is Language.DE:
        return escaped + _DE_ENDINGS
    if language is Language.RU:
        return escaped + "[а-я]{0,6}"
    # Turkish
    stem = escaped
    vowels = sum(ch in _VOWELS for ch in word)
    if word[-1] in _TR_SOFTEN and vowels >= 2:
        stem = f"(?:{escaped}|{re.escape(word[:-1] + _TR_SOFTEN[word[-1]])})"
    suffix = "[a-z]{0,10}" if len(word) >= 4 else _TR_SHORT_SUFFIXES
    return stem + (f"(?P<sfx>{suffix})" if last else suffix)
Danach behält der Matcher die längsten Treffer, die sich nicht überlappen. So gewinnt „peanut butter" gegen „butter" und „Buchweizen" gegen „Weizen". Ein türkisches Suffix, das mit „-sız" („ohne") beginnt, wird als „frei von" gemeldet und nie als das Allergen gezählt.
Ein Fehler, den ich gefunden und behoben habe
Deutsche Adjektive galten als unbekannte Wörter
Was kaputt war
Der erste Lauf über meine selbst gekennzeichnete Stichprobe fand alle erwarteten Allergene, schickte aber 42 von 116 Zeilen zur Prüfung an einen Menschen. „gehackte Walnüsse" und „geriebener Parmesan" wurden markiert, obwohl „gehackt" und „gerieben" im Wörterbuch stehen; sogar „frische Kräuter". Nichts wurde übersehen, aber ein Werkzeug, das ständig falschen Alarm schlägt, wird irgendwann ignoriert.
Ursache
Deutsche Wörter werden auch innerhalb von Komposita gesucht, deshalb hat ihr Muster keine
Wortgrenzen, und ich hatte die Endungen weggelassen: „gehackt" deckte nur einen Teil von
„gehackte" ab. Ein Wort, das nur teilweise von einem bekannten Wort abgedeckt ist, gilt
absichtlich als unbekannt (sonst ließe „Salat" auch „Waldorfsalat" harmlos aussehen). Nach dem
Hinzufügen der Endungen scheiterte „geriebener" trotzdem: In (?:e|en|er…) nimmt der reguläre
Ausdruck die erste passende Alternative, und ohne Wortgrenze dahinter reicht immer „e".
Die Lösung
Kompositum-Muster nehmen jetzt die Endungen an, die längste zuerst. Die markierten Zeilen gingen von 42 auf 40 zurück, gefunden wurden weiterhin 104 von 104 Allergenen, und ein Regressionstest sorgt dafür, dass die Adjektive bekannt bleiben.
_DE_ENDINGS = "(?:e|en|er|ern|n|s|es)?"

    if compound:
return re.escape(words[0])_DE_ENDINGS = "(?:ern|en|er|es|e|n|s)?"
if compound:
return re.escape(words[0]) + _DE_ENDINGSErgebnis
- 220 automatische Tests: jede der 14 Gruppen mit einem Wort in jeder der vier Sprachen, Morphologie, falsche Freunde, alle Ausnahmen aus Anhang II, die Bestätigungsregeln und der Claude-Client gegen einen nachgebauten HTTP-Server.
- Auf einer selbst gekennzeichneten Stichprobe von 116 Zutatenzeilen in vier Sprachen: 104 von 104 Allergenen für den Koch vorausgewählt, 0 stille Fehler, 40 Zeilen zur Prüfung an einen Menschen, meist wegen Wörtern wie „tinned" oder „Bio", die das Wörterbuch nicht kennt.
- Der Demo-Modus läuft offline: 16 Beispielgerichte, darunter Menemen, Mercimek Çorbası und Baklava, mit Namen in vier Sprachen.