Allergen Labels
Отмечает 14 аллергенов ЕС в каждом блюде на четырёх языках и ничего не печатает, пока шеф не подтвердит.
- Роль
- Личный проект — проектирование, код, тесты
- Год
- 2026
- Категория
- ИИ · Веб
- Стек
- Python 3.12, FastAPI, Jinja2, SQLite
Проблема
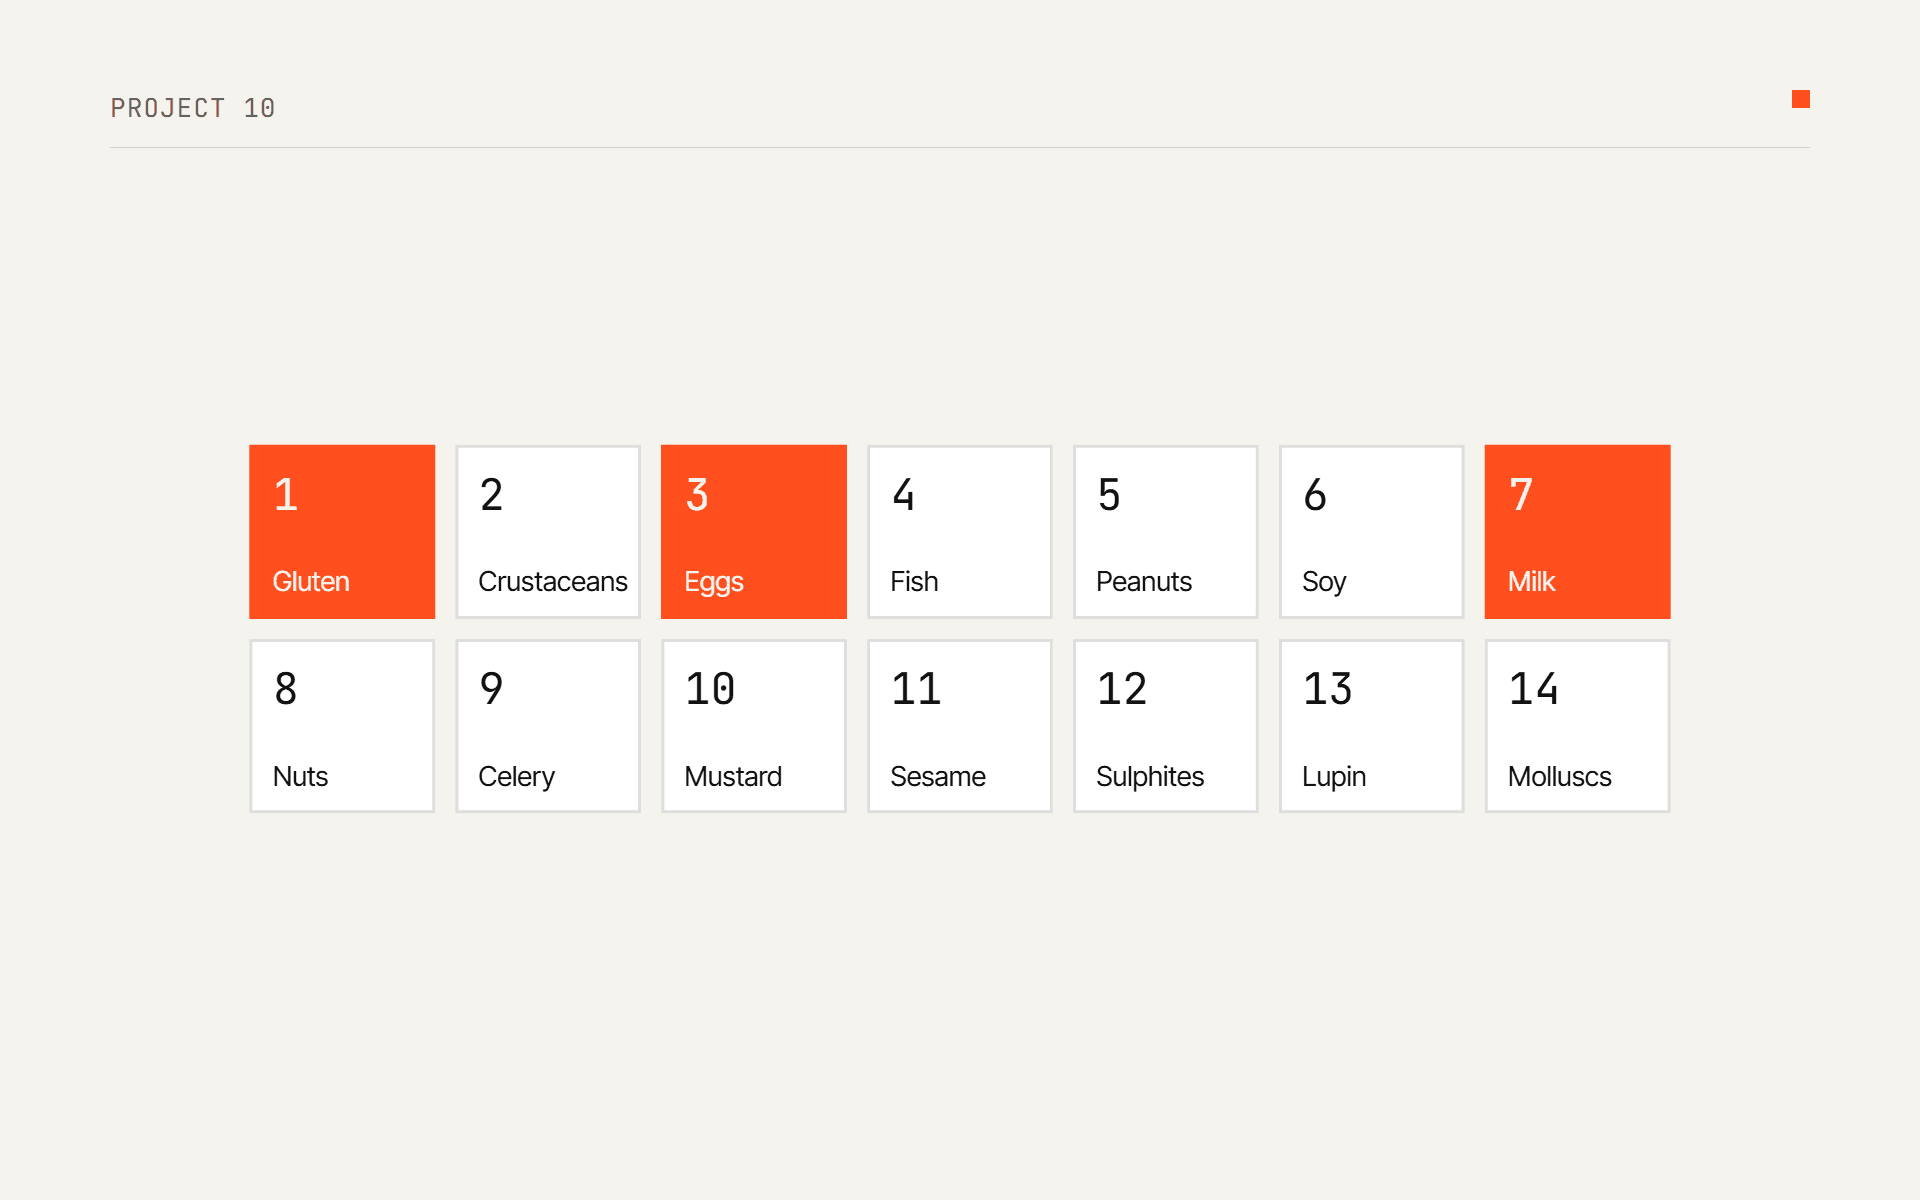
Закон ЕС о пищевой информации (Регламент 1169/2011, статья 9(1)(c) и Приложение II) требует указывать 14 групп аллергенов, а статья 44 делает это обязательным для еды без упаковки, то есть для ресторанов и кухонь отелей. Как именно показывать эту информацию, решает каждая страна.
Сложность не в самом списке. Кухня постоянно меняет рецепты: бульонный кубик от нового поставщика, кешью вместо кедровых орехов в песто, сливочное масло в соусе, где раньше было растительное. Номера аллергенов в меню пишут один раз, и они устаревают. В Анталье одно и то же меню читают туристы на разных языках, и гостю с аллергией на орехи остаётся доверять цифре рядом с названием блюда.
Решение
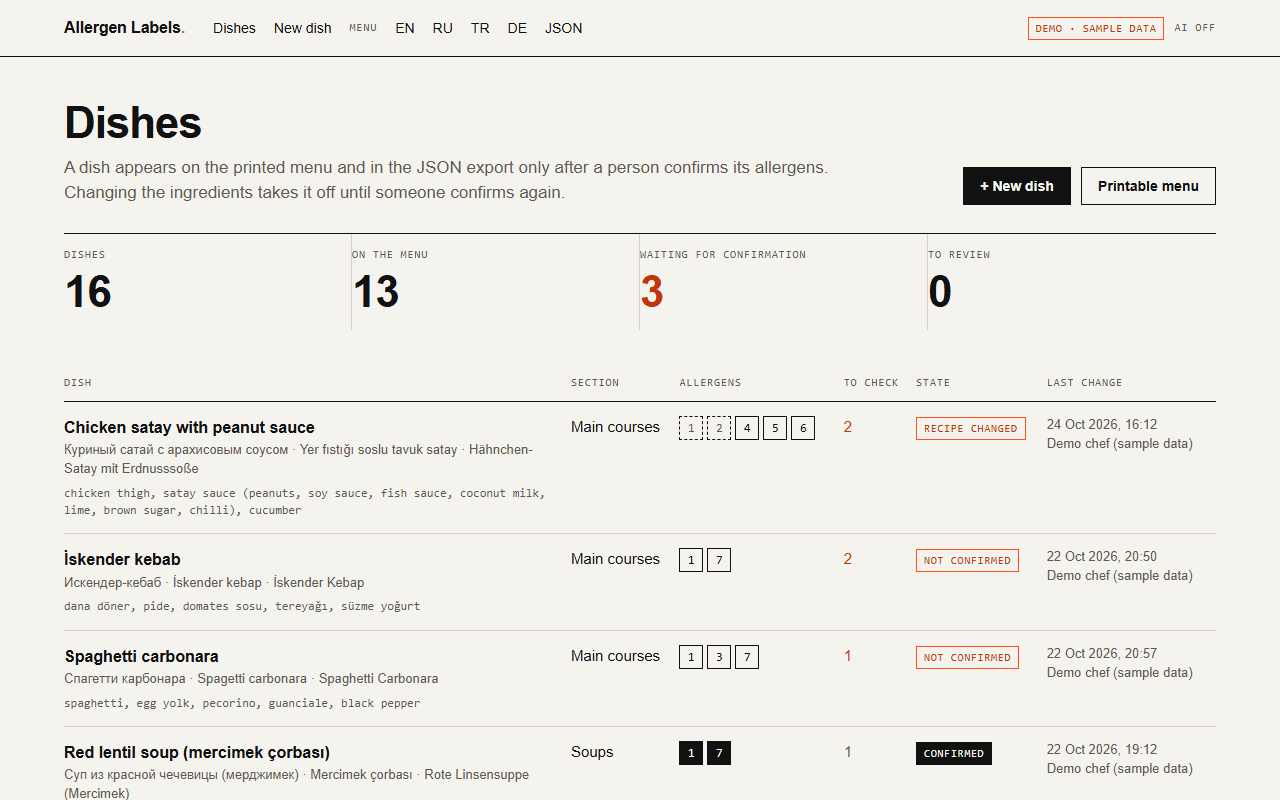
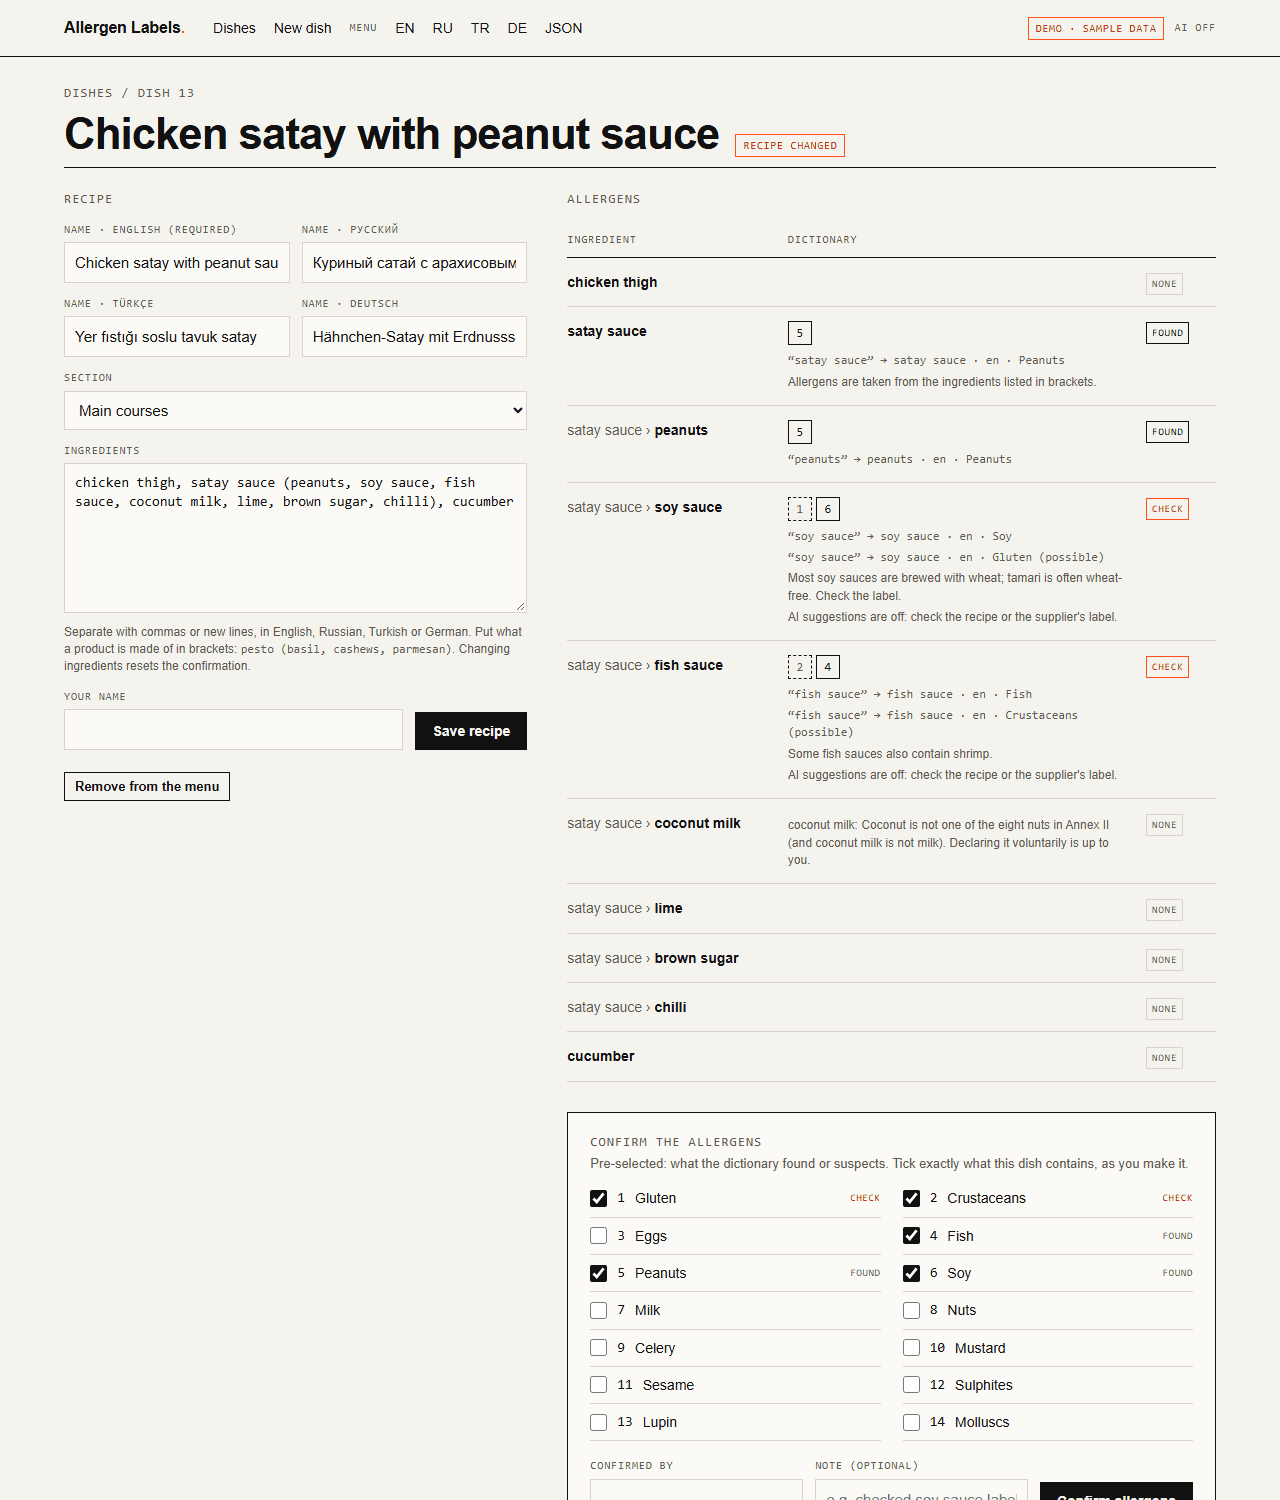
- Шеф вводит ингредиенты так, как их пишут на кухне: на английском, русском, турецком или немецком. Курируемый словарь из 2429 фраз находит аллергены и для каждой находки показывает слово, из которого она взялась.
- Он понимает множественное число, русские падежи («сметаной»), турецкие суффиксы («fındığı», «peynirli») и немецкие составные слова («Haselnusskrokant»), с диакритикой и без неё.
- У составных продуктов есть типичные аллергены: «соевый соус» — это соя и возможно глютен, «песто» — возможно молоко и орехи. Если написать
pesto (basil, cashews, parmesan), догадку заменяют настоящие составляющие. - То, что похоже на аллерген, но не входит в Приложение II, объясняется, а не отмечается: кокос, кедровые орехи, мускатный орех, гречка, глюкозный сироп. «Безлактозное молоко» остаётся молоком.
- Незнакомые и неоднозначные слова («fıstık» — арахис или фисташки, «масло» — сливочное или растительное) отмечаются для человека. С API-ключом Claude предлагает группы с коротким объяснением и пометкой «нужно подтверждение»; без ключа такие слова просто отмечаются.
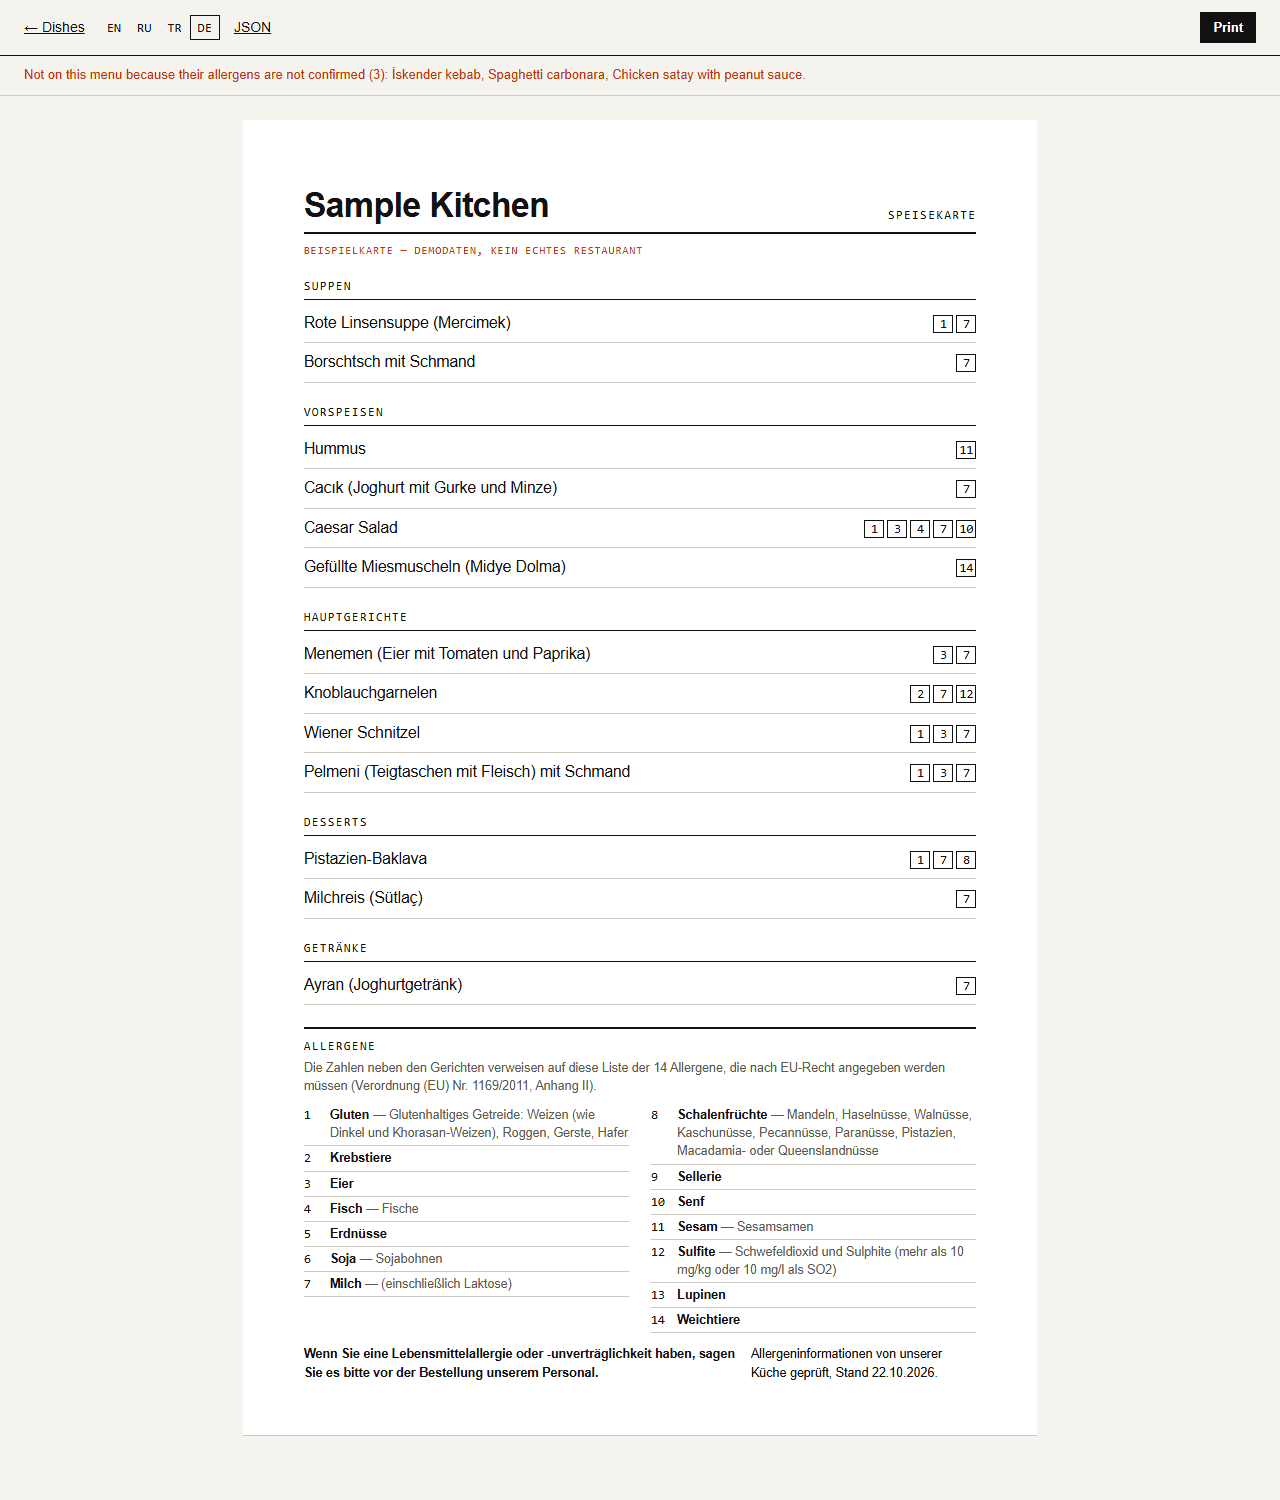
- Ничего не публикуется, пока человек не подтвердит блюдо своим именем. Каждое подтверждение записывается в журнал; изменение ингредиентов его сбрасывает; страница, открытая до того, как кто-то другой поменял рецепт, подтвердить его не может.
- Печатное меню на четырёх языках с номерами аллергенов и легендой, плюс экспорт в JSON.
Скриншоты
Технологии
- Python 3.12
- FastAPI
- Jinja2
- SQLite
- Anthropic API
- pytest
- Docker
Основную работу делает словарь, и он работает без интернета. LLM видит только те ингредиенты, с которыми словарь не справился; её ответ — JSON по схеме, где поле аллергенов ограничено перечнем 14 идентификаторов групп, и он лишь заранее ставит галочки в форме подтверждения. Триггеры SQLite делают журнал подтверждений неизменяемым: записи можно только добавлять. Веб-интерфейс — обычные HTML-формы, JavaScript не нужен.
Фрагмент кода
Каждая фраза словаря превращается в регулярное выражение для «свёрнутого» текста (нижний регистр, без диакритики, турецкие «İ/ı» приведены к одному виду). У каждого языка свои формы слова:
def _word(word: str, language: Language, last: bool, exact: bool) -> str:
    escaped = re.escape(word)
    if exact:
        return escaped
    if language is Language.EN:
        if not last:
            return escaped
        if len(word) > 2 and word.endswith("y") and word[-2] not in _VOWELS:
            return re.escape(word[:-1]) + "(?:y|ies)"
        return escaped + "(?:s|es)?"
    if language is Language.DE:
        return escaped + _DE_ENDINGS
    if language is Language.RU:
        return escaped + "[а-я]{0,6}"
    # Turkish
    stem = escaped
    vowels = sum(ch in _VOWELS for ch in word)
    if word[-1] in _TR_SOFTEN and vowels >= 2:
        stem = f"(?:{escaped}|{re.escape(word[:-1] + _TR_SOFTEN[word[-1]])})"
    suffix = "[a-z]{0,10}" if len(word) >= 4 else _TR_SHORT_SUFFIXES
    return stem + (f"(?P<sfx>{suffix})" if last else suffix)
Затем матчер оставляет самые длинные непересекающиеся совпадения, поэтому «peanut butter» побеждает «butter», а «Buchweizen» (гречка) — «Weizen» (пшеницу). Турецкий суффикс «-sız» («без») считается словом «без аллергена» и никогда не засчитывается как сам аллерген.
Баг, который я нашёл и исправил
Немецкие прилагательные считались незнакомыми словами
Что сломалось
Первый прогон на моей размеченной выборке нашёл все ожидаемые аллергены, но отправил на проверку человеку 42 строки из 116. «gehackte Walnüsse» и «geriebener Parmesan» попадали на проверку, хотя «gehackt» и «gerieben» есть в словаре; даже «frische Kräuter» попадала. Ничего не было пропущено, но инструмент, который зря поднимает тревогу, перестают слушать.
Причина
Немецкие слова ищутся и внутри составных слов, поэтому у их шаблона нет границ слова, а
окончания я не добавил: «gehackt» покрывал только часть «gehackte». Слово, частично покрытое
только известным словом, специально считается незнакомым (иначе «Salat» сделал бы
безобидным «Waldorfsalat»). После добавления окончаний «geriebener» всё равно не проходил:
в (?:e|en|er…) регулярное выражение берёт первый подходящий вариант, а без границы после
него всегда хватает «e».
Исправление
Шаблоны составных слов теперь принимают окончания, самые длинные — первыми. Строк на проверку стало 40 вместо 42, найдено по-прежнему 104 аллергена из 104, а регрессионный тест не даёт прилагательным снова стать незнакомыми.
_DE_ENDINGS = "(?:e|en|er|ern|n|s|es)?"

    if compound:
return re.escape(words[0])_DE_ENDINGS = "(?:ern|en|er|es|e|n|s)?"
if compound:
return re.escape(words[0]) + _DE_ENDINGSРезультат
- 220 автоматических тестов: каждая из 14 групп со словом на каждом из четырёх языков, морфология, «ложные друзья», все исключения Приложения II, правила подтверждения и клиент Claude против поддельного HTTP-сервера.
- На выборке из 116 строк ингредиентов на четырёх языках, которую я разметил сам: 104 из 104 аллергенов заранее отмечены для шефа, 0 тихих пропусков, 40 строк отправлены на проверку человеку — в основном из-за слов вроде «tinned» или «Bio», которых нет в словаре.
- Демо-режим работает без интернета: 16 демо-блюд, среди них менемен, мерджимек-чорбасы и пахлава, с названиями на четырёх языках.