Helpdesk Copilot
Ein IT-Assistent, der Mitarbeitenden aus den eigenen Anleitungen der Firma mit nummerierten Quellen antwortet und alles andere in ein priorisiertes Ticket verwandelt.
- Rolle
- Eigenes Projekt — Konzept, Code, Tests
- Jahr
- 2026
- Kategorie
- KI · Bots
- Technologien
- Python 3.12, Anthropic API, BM25, aiogram 3
Das Problem
In einer kleinen Firma ist die IT-Abteilung eine Person oder ein externer Dienstleister, der nach Stunden abrechnet. Ein großer Teil des Tages besteht aus denselben zwanzig Fragen: das Gäste-WLAN-Passwort, das VPN von zu Hause, ein hängender Druckauftrag, MFA auf dem neuen Handy. Die Antworten stehen meist irgendwo geschrieben, und niemand liest sie.
Ein allgemeiner Chatbot beantwortet solche Fragen selbstsicher und falsch. Er kennt die Netzwerknamen, Durchwahlen und Regeln dieser Firma nicht, und Menschen tun, was ein IT-Assistent ihnen sagt. Für kleine Firmen und IT-Dienstleister ist das ein häufiges erstes KI-Projekt, deshalb wollte ich es richtig bauen: Antworten nur aus den eigenen Anleitungen der Firma, eine sichtbare Quelle für jeden Satz, eine gemessene Auswertung und ein Mensch für alles andere.
Die Lösung
- Die Wissensbasis ist ein Ordner mit Markdown-Anleitungen, ein
## Sectionpro Aufgabe. Für die Demo habe ich 15 davon für ein fiktives „Sample Office“ geschrieben: WLAN, Gäste-WLAN, VPN, Drucker, Passwörter, MFA, geteilte Postfächer, Phishing, Backups und mehr. - Die Suche ist BM25 über Abschnitte, ohne ML-Bibliotheken. Eine leichte Normalisierung (ohne Akzente, einfaches Stemming, ein kleines deutsch-russisch-türkisches Glossar mit IT-Wörtern) lässt „Mein Druckauftrag hängt“ den englischen Abschnitt „Print job is stuck“ finden.
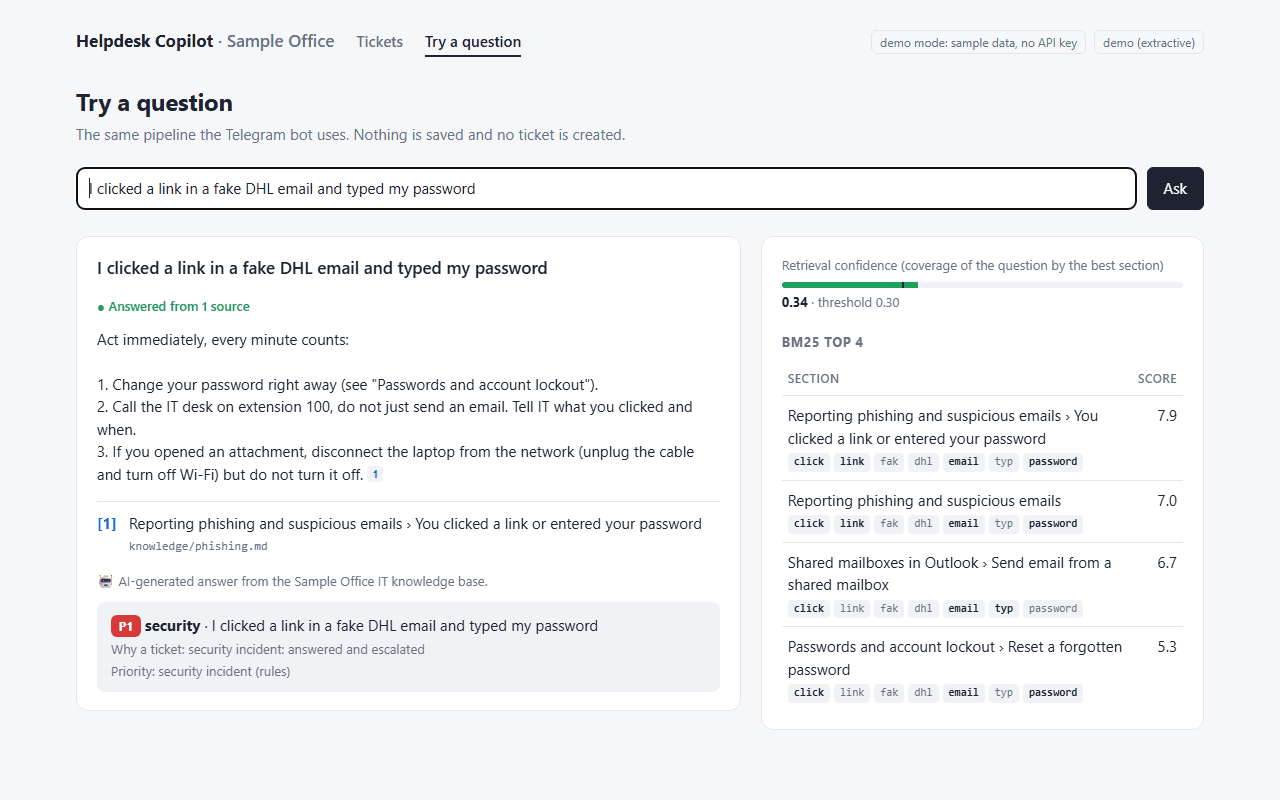
- Claude antwortet nur aus den gefundenen Abschnitten und zitiert sie als [1], [2]. Der Code prüft jedes Zitat; eine Antwort ohne gültige Quelle wird nie angezeigt.
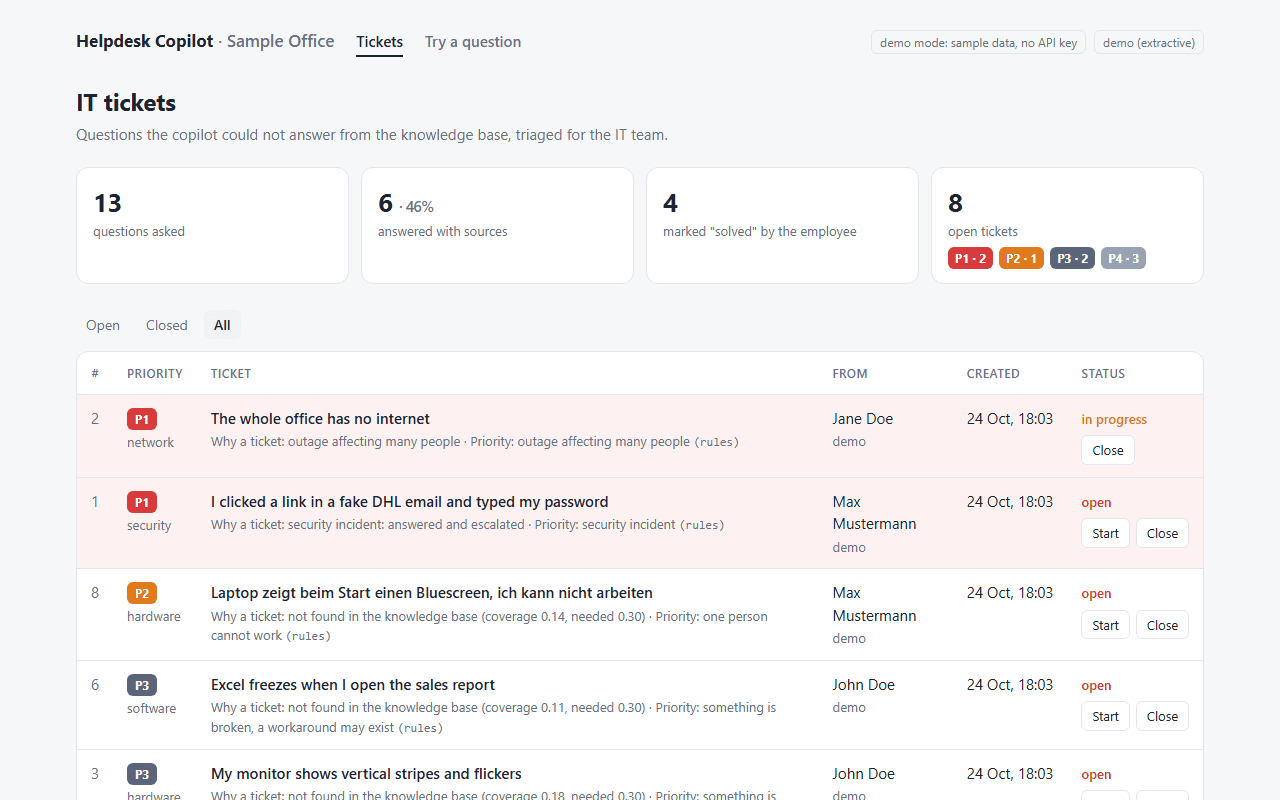
- Alles, was sich nicht beantworten lässt, wird ein Ticket mit Kategorie, Priorität von P1 bis P4 und einer einzeiligen Zusammenfassung. Phishing und ein Ausfall im ganzen Büro sind immer P1, und das Modell kann das nicht herabstufen.
- In Telegram bekommt die Person die Antwort mit Quellen und zwei Buttons: Solved (gelöst) oder Create ticket (Ticket erstellen). Neue Tickets gehen in den IT-Chat; die IT-Person bearbeitet sie auf einer kleinen Webseite.
- Der Bot sagt in
/startund unter jeder Antwort, dass er eine KI ist, wie es Artikel 50 der KI-Verordnung der EU (AI Act) für Systeme verlangt, die mit Menschen sprechen.
Screenshots
Technologien
- Python 3.12
- Anthropic API
- BM25
- aiogram 3
- FastAPI
- Jinja2
- SQLite
- pytest
BM25 statt Embeddings: Für ein paar Dutzend Seiten ist es schnell (unter 0,2 ms pro Frage), braucht weder Modell noch Vektordatenbank, und seine Entscheidungen lassen sich auf dem Bildschirm zeigen. Die billigsten Prüfungen laufen zuerst, sodass eine Frage, die die Anleitungen nicht abdecken, ohne einen einzigen bezahlten API-Aufruf zum Ticket wird. Ohne API-Schlüssel läuft die App im Demo-Modus: Sie zitiert den besten Abschnitt und priorisiert nach Regeln.
Code im Detail
Die ganze Entscheidung, unabhängig von Telegram, sodass Bot, Webseite, Auswertung und Tests denselben Code ausführen:
async def decide(self, question: str) -> Decision:
    retrieval = self.retriever.search(question, self.top_k)
    urgent = urgency(question)

    if urgent is Urgency.OUTAGE:
        return Decision(retrieval, route=Route.OUTAGE)
    if is_action_request(question):
        return Decision(retrieval, route=Route.ACTION)
    if not retrieval.confident:  # no LLM call for what the how-tos cannot support
        return Decision(retrieval, route=Route.NOT_FOUND)

    sources = number_sources([hit.section for hit in retrieval.hits])
    try:
        draft = await self.llm.answer(question, sources)
    except LLMError:
        draft = await self.fallback.answer(question, sources)  # extractive, still grounded

    if not draft.answered or not draft.answer.strip():
        return Decision(retrieval, route=Route.NO_ANSWER)
    check = check_citations(draft.answer, sources)
    if not check.grounded:
        return Decision(retrieval, route=Route.NO_CITATION)

    route = Route.SECURITY if urgent is Urgency.SECURITY else None
    return Decision(retrieval, check.text, check.cited, route=route)
Ein Fehler, den ich gefunden und behoben habe
„Im ganzen Büro kein Internet“ landete als Zugriffsproblem
Was kaputt war
Als ich die Priorisierungsregeln über die Fragen der Auswertung laufen ließ, bekam der Ausfall im ganzen Büro die richtige Priorität P1, aber die Kategorie access (Zugriff), neben Passwort-Resets. Eine Frage nach Internet für Workshop-Gäste landete an derselben Stelle.
Ursache
Schlüsselwörter werden am Wortanfang gesucht, damit „phish“ auch „phishing“ und „Phishing-Mail“ findet. Deshalb passte das Zugriffs-Schlüsselwort „intern“ (Konten für Praktikanten) auch auf „internet“, und bei Gleichstand wurde access vor network geprüft.
Die Lösung
Ein Schlüsselwort kann jetzt mit einem $ am Ende ein ganzes Wort verlangen, und aus „intern“
wurde „intern$“. Außerdem gewinnt network jetzt einen Gleichstand gegen access. Ein Test prüft
„No internet on my laptop“ (network) neben „Account for our new intern“ (access).
folded = fold(phrase.strip())
parts.append(part + r"\b" if len(folded) <= 3 else part)

ACCESS = keywords("... contractor, intern, passwort, ...")folded = fold(phrase.strip())
whole = folded.endswith("$") or len(folded) <= 3
folded = folded.rstrip("$")
parts.append(part + r"\b" if whole else part)
ACCESS = keywords("... contractor, intern$, passwort, ...")Ergebnis
- 110 automatisierte Tests: Ranking, Zitatprüfung, jeder Weg zum Ticket, die Priorisierungsregeln, der Claude-Client gegen einen nachgebauten API-Server und der Telegram-Bot von Anfang bis Ende mit einer nachgebauten Telegram-Sitzung.
- Suche bei 30 Testfragen in vier Sprachen: Das richtige Dokument steht bei 29 von 30 an erster Stelle und bei 30 von 30 unter den ersten drei. Bei 15 zurückgehaltenen Fragen, die erst ganz am Ende einmal bewertet wurden: 14 von 15 und 15 von 15.
- Alle 13 Fragen, die die Anleitungen nicht abdecken, wurden in der Auswertung zu Tickets. Im README führe ich auch drei Fragen auf, die bei der Vorbereitung der Demo durchgerutscht sind, und warum.
- Die Antwortqualität mit Claude ist noch nicht gemessen; dafür braucht es einen API-Schlüssel. [Ergebnisse der Auswertung mit Claude]