Helpdesk Copilot
IT-ассистент, который отвечает сотрудникам по инструкциям самой компании с пронумерованными источниками, а всё остальное превращает в разобранную по приоритетам заявку.
- Роль
- Личный проект — проектирование, код, тесты
- Год
- 2026
- Категория
- ИИ · Боты
- Стек
- Python 3.12, Anthropic API, BM25, aiogram 3
Проблема
В небольшой компании IT-отдел — это один человек или внешний подрядчик с почасовой оплатой. Большая часть его дня — одни и те же двадцать вопросов: пароль от гостевого Wi-Fi, VPN из дома, зависшая печать, MFA на новом телефоне. Ответы обычно где-то записаны, но их никто не читает.
Обычный чат-бот отвечает на такие вопросы уверенно и неправильно. Он не знает названий сетей, внутренних номеров и правил этой компании, а люди делают то, что им говорит IT-помощник. Это частый первый AI-проект для небольших компаний и IT-подрядчиков, поэтому я хотел сделать его как следует: ответы только по инструкциям самой компании, видимый источник у каждого предложения, измеренная оценка качества и живой человек для всего остального.
Решение
- База знаний — папка инструкций в Markdown, один раздел
## Sectionна одну задачу. Для демо я написал 15 инструкций для вымышленного «Sample Office»: Wi-Fi, гостевой Wi-Fi, VPN, принтеры, пароли, MFA, общие почтовые ящики, фишинг, резервные копии и другие. - Поиск — BM25 по разделам, без ML-библиотек. Лёгкая нормализация (без диакритики, простой стемминг, небольшой немецко-русско-турецкий глоссарий IT-слов) позволяет запросу «Mein Druckauftrag hängt» найти английский раздел «Print job is stuck».
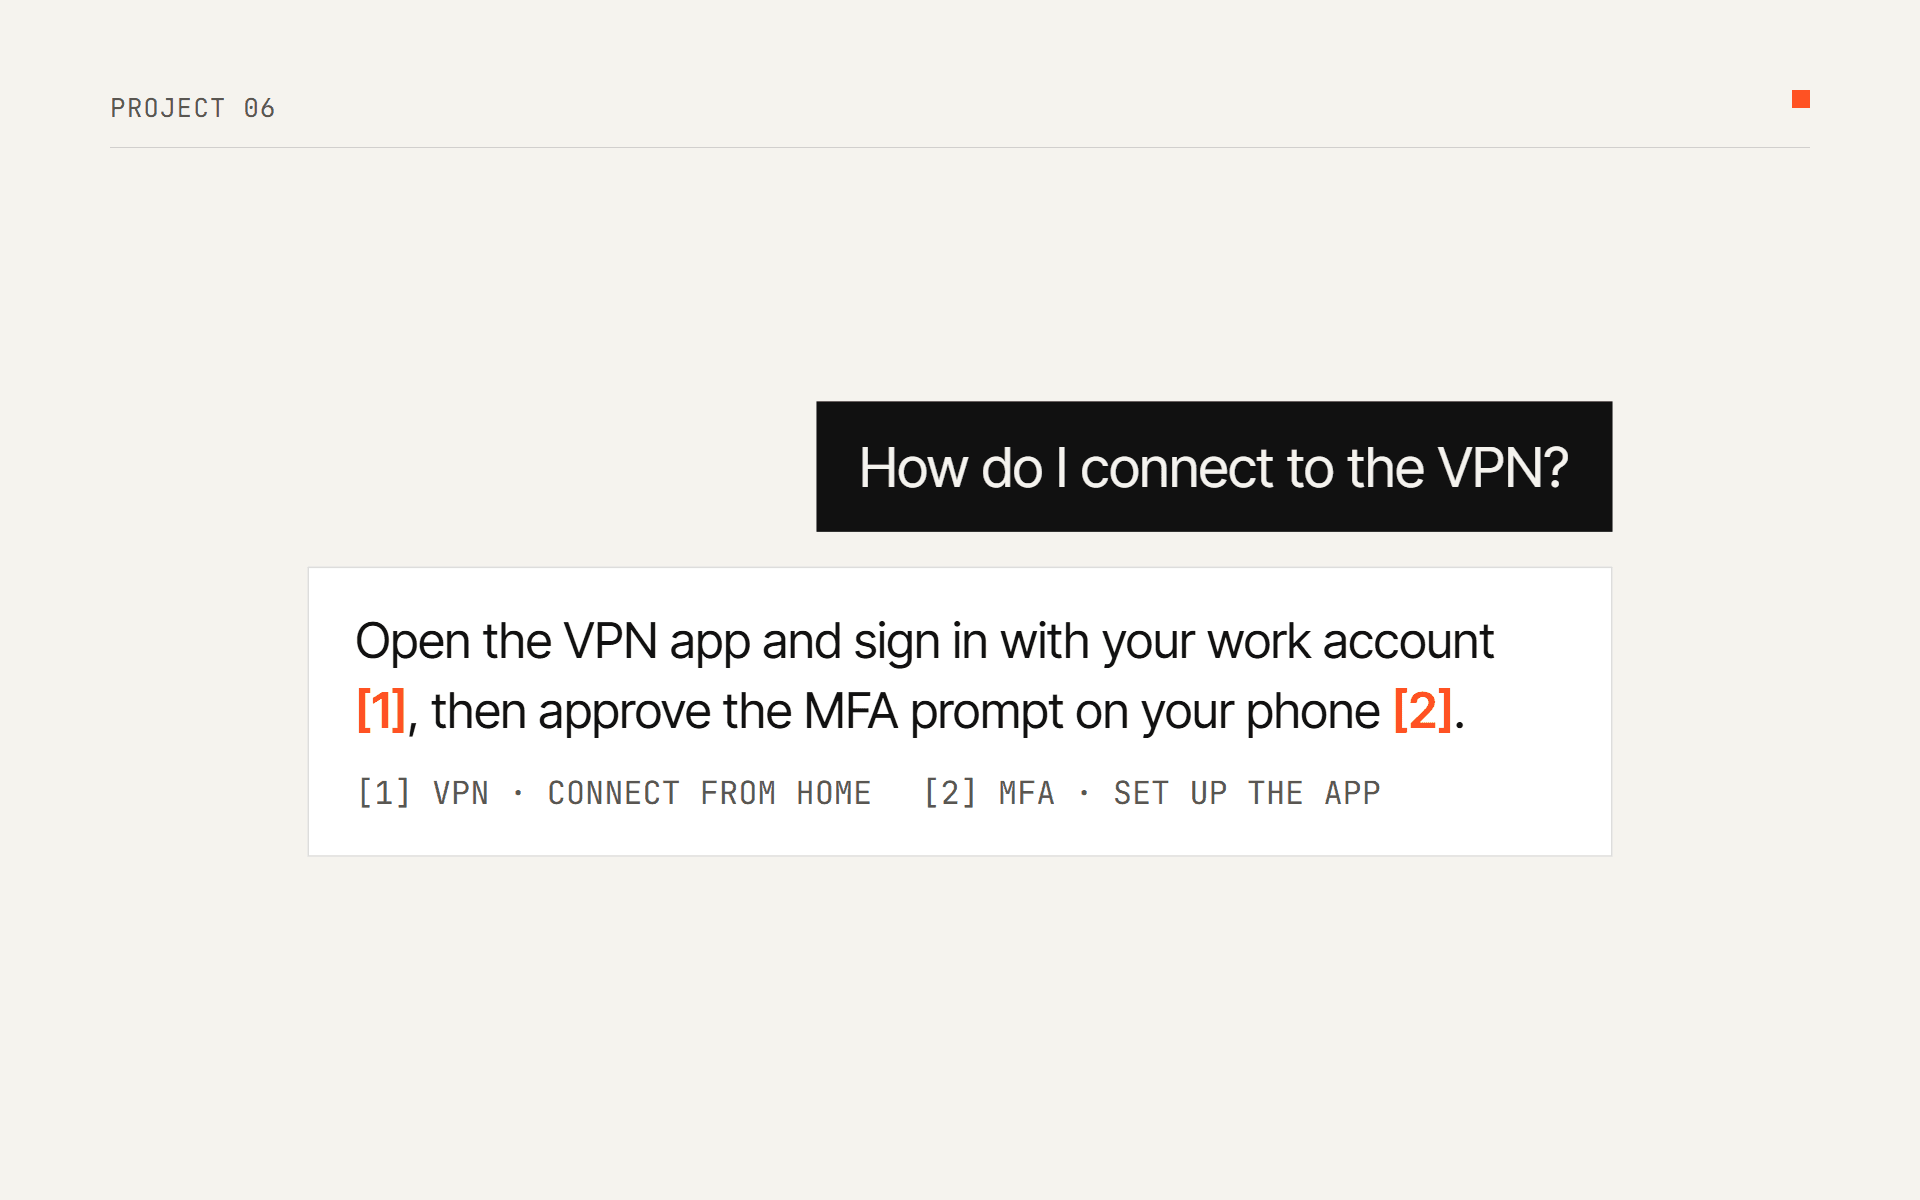
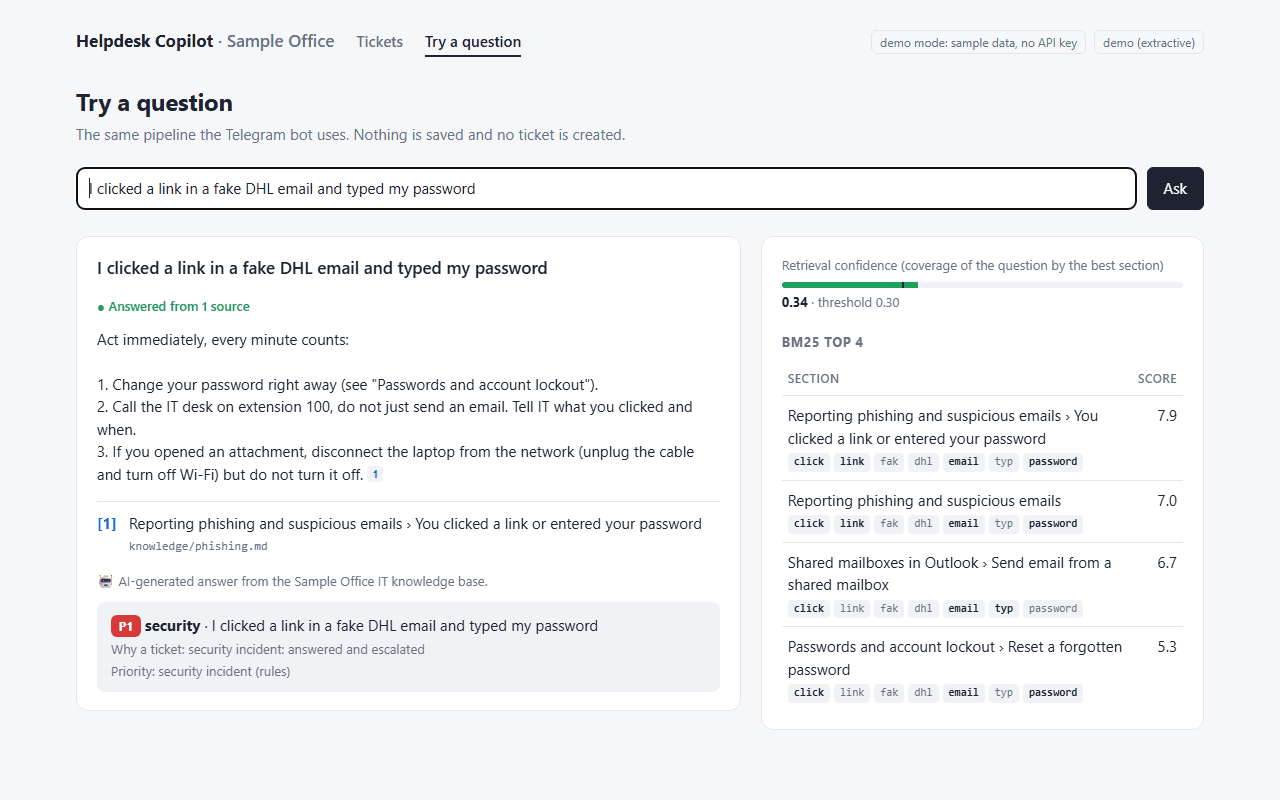
- Claude отвечает только по найденным разделам и ссылается на них как [1], [2]. Код проверяет каждую ссылку; ответ без настоящего источника никогда не показывается.
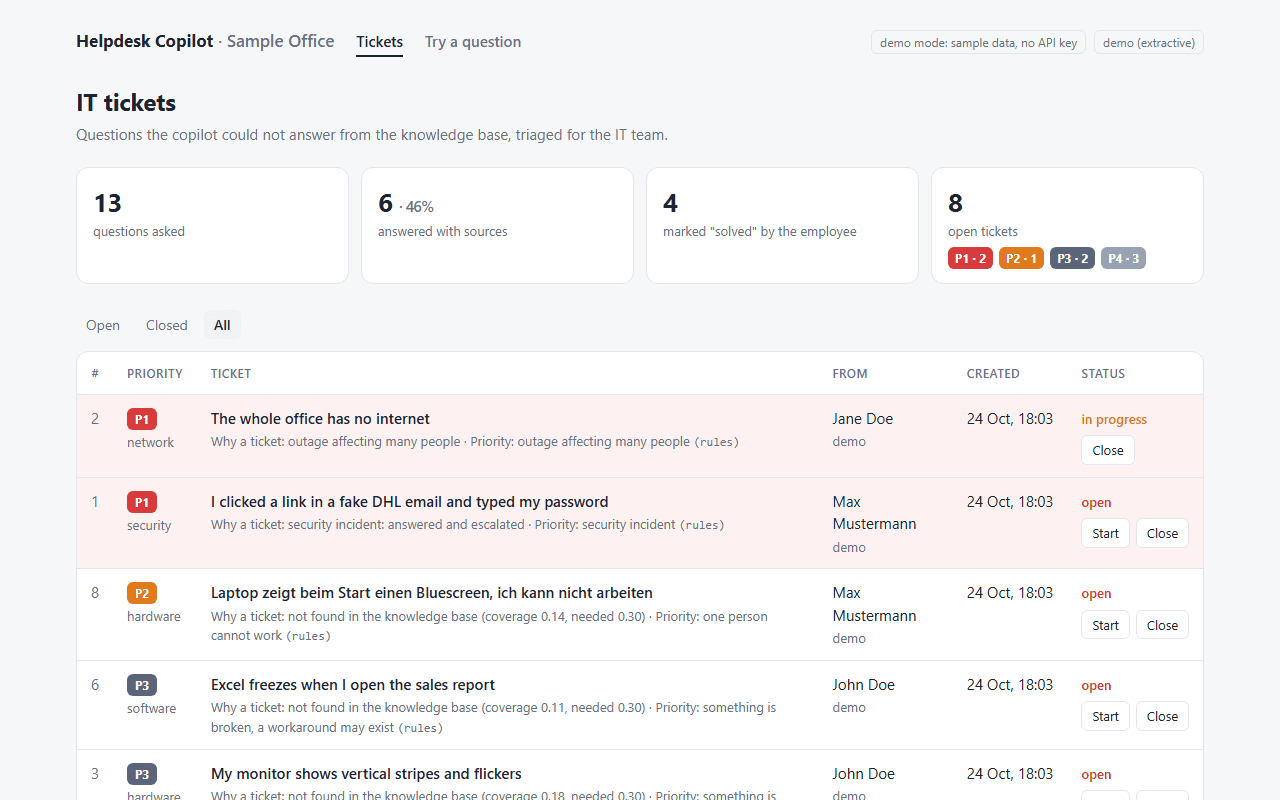
- Всё, на что ответить нельзя, становится заявкой с категорией, приоритетом от P1 до P4 и кратким описанием в одну строку. Фишинг и авария во всём офисе — всегда P1, и модель не может это понизить.
- В Telegram сотрудник получает ответ с источниками и две кнопки: Solved («Решено») или Create ticket («Создать заявку»). Новые заявки приходят в чат IT; айтишник разбирает их на небольшой веб-странице.
- Бот сообщает, что он ИИ, в
/startи под каждым ответом, как требует статья 50 Регламента ЕС об ИИ (AI Act) для систем, которые общаются с людьми.
Скриншоты
Технологии
- Python 3.12
- Anthropic API
- BM25
- aiogram 3
- FastAPI
- Jinja2
- SQLite
- pytest
BM25 вместо эмбеддингов: для нескольких десятков страниц он быстрый (меньше 0,2 мс на вопрос), не требует модели и векторной базы, а его решения можно показать на экране. Сначала выполняются самые дешёвые проверки, поэтому вопрос, на который в инструкциях нет ответа, становится заявкой без единого платного запроса к API. Без ключа API приложение работает в демо-режиме: цитирует лучший раздел и разбирает заявки по правилам.
Фрагмент кода
Всё решение целиком, без привязки к Telegram, поэтому бот, веб-страница, оценка и тесты выполняют один и тот же код:
async def decide(self, question: str) -> Decision:
    retrieval = self.retriever.search(question, self.top_k)
    urgent = urgency(question)

    if urgent is Urgency.OUTAGE:
        return Decision(retrieval, route=Route.OUTAGE)
    if is_action_request(question):
        return Decision(retrieval, route=Route.ACTION)
    if not retrieval.confident:  # no LLM call for what the how-tos cannot support
        return Decision(retrieval, route=Route.NOT_FOUND)

    sources = number_sources([hit.section for hit in retrieval.hits])
    try:
        draft = await self.llm.answer(question, sources)
    except LLMError:
        draft = await self.fallback.answer(question, sources)  # extractive, still grounded

    if not draft.answered or not draft.answer.strip():
        return Decision(retrieval, route=Route.NO_ANSWER)
    check = check_citations(draft.answer, sources)
    if not check.grounded:
        return Decision(retrieval, route=Route.NO_CITATION)

    route = Route.SECURITY if urgent is Urgency.SECURITY else None
    return Decision(retrieval, check.text, check.cited, route=route)
Баг, который я нашёл и исправил
«Во всём офисе нет интернета» попадало в категорию «доступ»
Что сломалось
Когда я прогнал правила триажа по вопросам из оценки, авария во всём офисе получила правильный приоритет P1, но категорию access («доступ») — рядом со сбросом паролей. Вопрос про интернет для гостей воркшопа оказался там же.
Причина
Ключевые слова ищутся с начала слова, чтобы «phish» находило и «phishing», и «Phishing-Mail». Поэтому ключевое слово категории access «intern» (учётки для стажёров) находило и «internet», а при равном счёте категория access проверялась раньше network.
Исправление
Теперь ключевое слово может требовать целое слово через $ в конце, и «intern» стало
«intern$». Кроме того, при равном счёте network теперь побеждает access. Тест проверяет
«No internet on my laptop» (network) рядом с «Account for our new intern» (access).
folded = fold(phrase.strip())
parts.append(part + r"\b" if len(folded) <= 3 else part)

ACCESS = keywords("... contractor, intern, passwort, ...")folded = fold(phrase.strip())
whole = folded.endswith("$") or len(folded) <= 3
folded = folded.rstrip("$")
parts.append(part + r"\b" if whole else part)
ACCESS = keywords("... contractor, intern$, passwort, ...")Результат
- 110 автоматических тестов: ранжирование, проверка ссылок, каждый путь к заявке, правила триажа, клиент Claude против поддельного API-сервера и Telegram-бот от начала до конца с поддельной сессией Telegram.
- Поиск на 30 тестовых вопросах на четырёх языках: нужный документ стоит первым в 29 из 30 случаев и входит в первую тройку в 30 из 30. На 15 отложенных вопросах, проверенных один раз в самом конце: 14 из 15 и 15 из 15.
- Все 13 вопросов, которых нет в инструкциях, в оценке стали заявками. В README я также привожу три вопроса, которые проскочили, пока я готовил демо, и объясняю почему.
- Качество ответов с Claude пока не измерено: для этого нужен ключ API. [Результаты оценки с Claude]