PII Guard
Ein Gateway, das personenbezogene Daten aus einem Prompt entfernt, bevor er ein LLM erreicht, und sie in die Antwort zurückschreibt.
- Rolle
- Eigenes Projekt — Konzept, Code, Tests
- Jahr
- 2026
- Kategorie
- KI · Web
- Technologien
- Python 3.12, FastAPI, HTMX, Jinja2
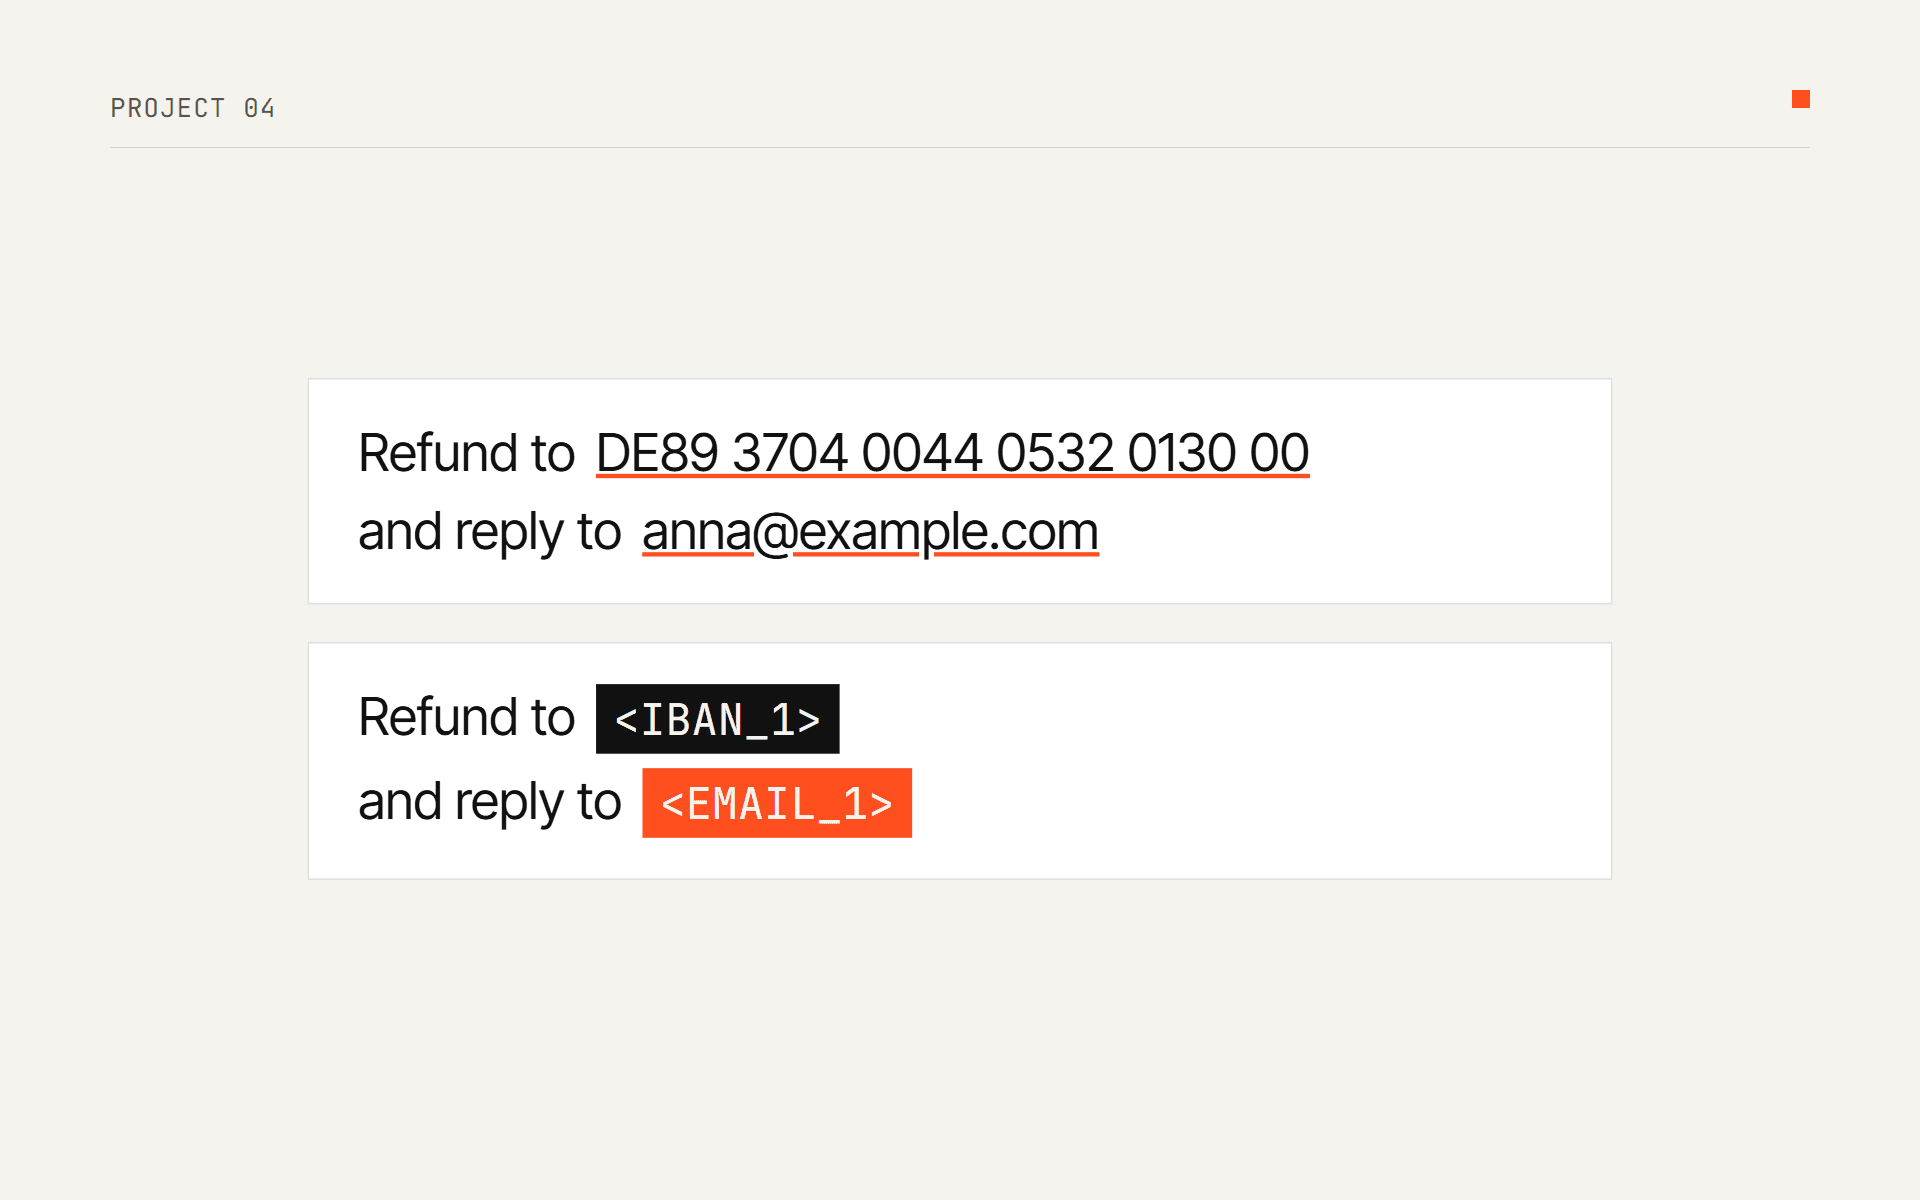
Das Problem
Unternehmen möchten, dass ihre Mitarbeitenden LLMs für alltägliche Textarbeit nutzen: „Schreib eine höfliche Antwort an diesen Kunden“, „Erklär mir dieses Log“. Solche Texte sind voller personenbezogener Daten: Namen, E-Mail-Adressen, Telefonnummern, IBANs. All das ginge an einen externen Anbieter.
Die DSGVO verlangt, personenbezogene Daten auf das für den Zweck notwendige Maß zu beschränken. Um eine Antwort zu einer Erstattung zu entwerfen, braucht das Modell nicht die echte IBAN. Es muss nur wissen, dass es eine gibt und wohin das Geld geht. Ich wollte sehen, wie weit man mit sorgfältiger Prüfung kommt, ganz ohne Machine-Learning-Modell.
Die Lösung
- Detektoren für E-Mail-Adressen, Telefonnummern, IBANs, Kartennummern, EU-USt-IdNrn., IPv4-Adressen und Geburtsdaten, jeweils mit einer echten Prüfung: Mod-97 für IBANs, Luhn plus Herausgeber-Präfix für Karten, die Nummerierungspläne von libphonenumber für Telefonnummern, das VIES-Format je Land für USt-IdNrn.
- Jeder Wert wird durch einen nummerierten Platzhalter ersetzt (
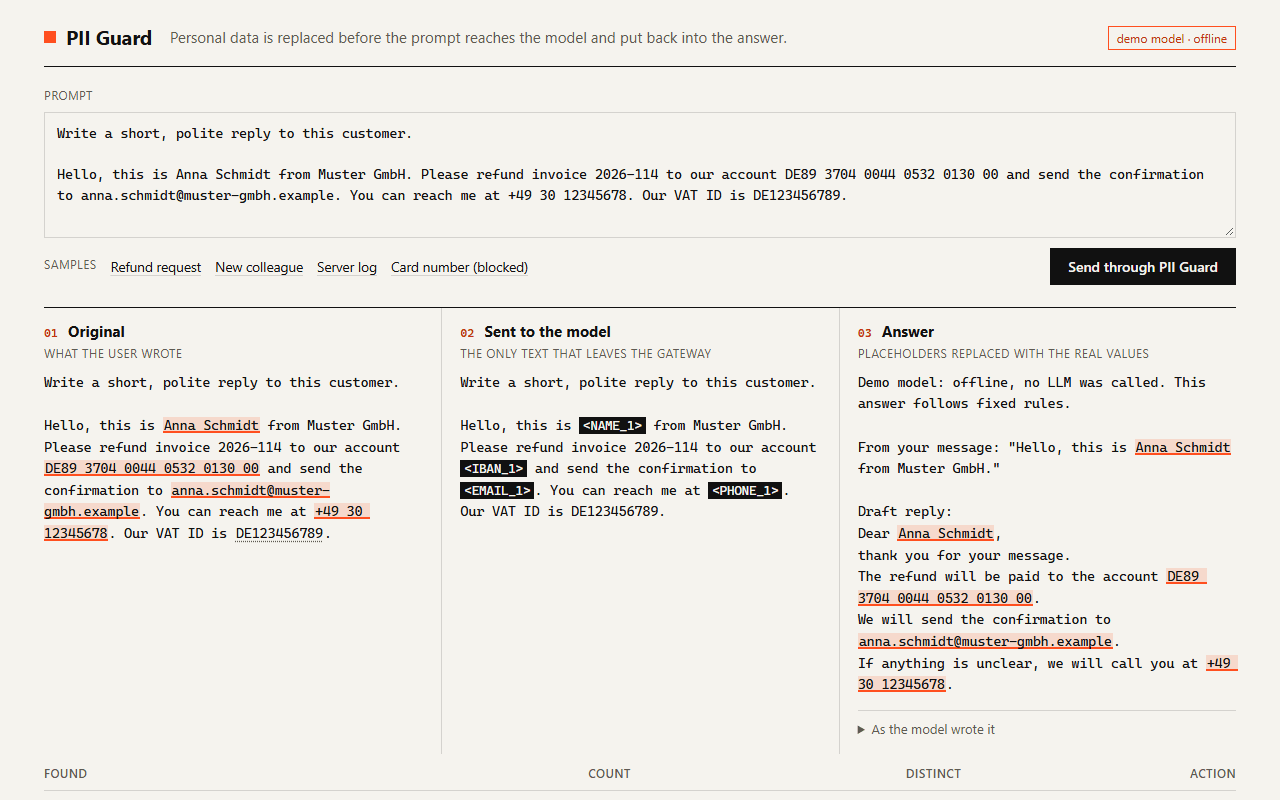
<EMAIL_1>,<IBAN_1>). Derselbe Wert bekommt im ganzen Gespräch immer denselben Platzhalter. - Nur der maskierte Text geht an das Modell (Claude über das Anthropic SDK oder ein Offline-Demo-Modell). Die echten Werte werden in die Antwort zurückgeschrieben, egal wie oft das Modell einen Platzhalter wiederholt.
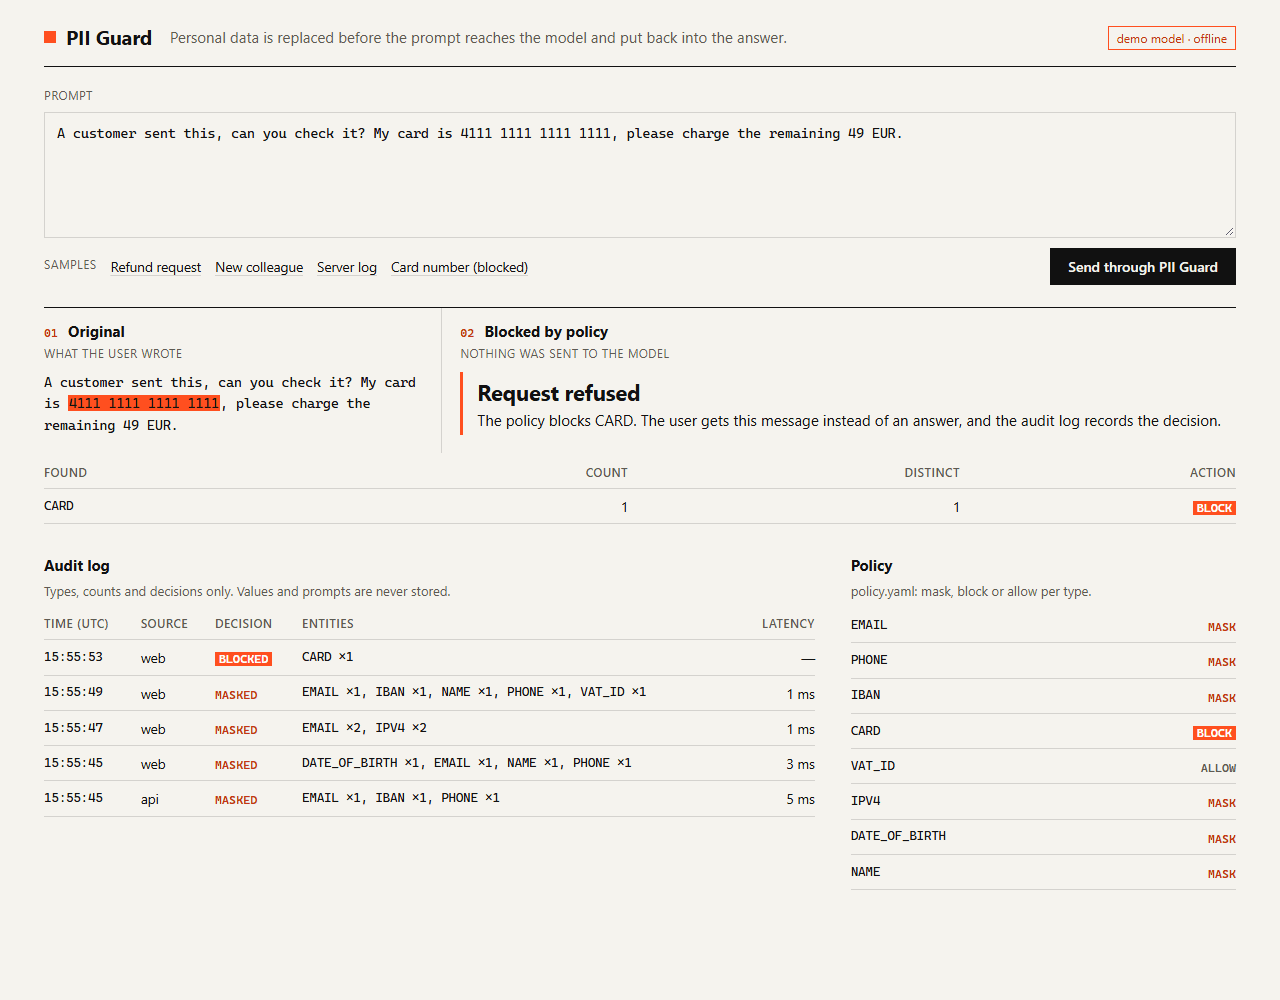
policy.yamlentscheidet je Typ: maskieren, die ganze Anfrage blockieren oder erlauben. Standardmäßig blockiert eine Kartennummer die Anfrage.- Im Zweifel ablehnen (fail closed): Bevor etwas gesendet wird, wird jeder Wert, der maskiert sein sollte, im ausgehenden Text gesucht. Steht einer noch darin, wird die Anfrage abgelehnt.
- Ein Audit-Log in SQLite speichert Zeit, Entscheidung, Datentypen und Anzahlen. Es hat keine einzige Spalte, in der ein Wert landen könnte.
- Eine JSON-API (
POST /v1/chat), eine Webseite, die Original, maskierten Text und Antwort nebeneinander zeigt, und eine CLI.
Screenshots
Technologien
- Python 3.12
- FastAPI
- HTMX
- Jinja2
- Anthropic API
- phonenumbers
- SQLite
- pytest
Namen sind die ehrliche Schwachstelle: Ohne NER-Modell (torch und spaCy habe ich bewusst weggelassen) werden nur Namen aus einer Liste gefunden, zum Beispiel aus einem CRM-Export. Telefonnummern werden mit den Metadaten von Googles libphonenumber geprüft, weil sich Nummerierungspläne von Land zu Land unterscheiden und mit der Zeit ändern. Die Zuordnung von Platzhaltern zu Werten existiert nur im Arbeitsspeicher und nur für eine Anfrage. Maskierte Prompts sind im Sinne der DSGVO weiterhin personenbezogene Daten (Erwägungsgrund 26), nur weniger davon. Deshalb beschreibt das README, was das Werkzeug tut, und verspricht niemandem „DSGVO-Konformität“.
Code im Detail
„Echte Prüfung“ heißt, dass ein Kandidat die Regel aus dem Standard bestehen muss, statt nur richtig auszusehen. Für eine IBAN ist das ISO 13616: die für das Land registrierte Länge, Prüfziffern zwischen 02 und 98 und der Rest 1 bei Division durch 97:
def iban_is_valid(value: str) -> bool:
    iban = compact(value)
    if not _IBAN_CHARS.fullmatch(iban):
        return False
    if IBAN_LENGTHS.get(iban[:2]) != len(iban):
        return False
    if not 2 <= int(iban[2:4]) <= 98:
        return False
    # Move country code and check digits to the end, then A=10 ... Z=35.
    rearranged = iban[4:] + iban[:4]
    number = "".join(str(int(char, 36)) for char in rearranged)
    return int(number) % 97 == 1
Ein Fehler, den ich gefunden und behoben habe
Die Leck-Prüfung vertraute dem Schritt, den sie prüfen sollte
Was kaputt war
Nach dem Maskieren sucht das Gateway im ausgehenden Text nach jedem Wert, der dort nicht mehr stehen darf, und lehnt die Anfrage ab, wenn einer noch da ist. Ich habe einen Test geschrieben, der die Maskierungsfunktion durch eine kaputte ersetzt, die den Text unverändert zurückgibt. Der Test erwartete eine Ablehnung. Die Anfrage ging durch, mit der echten IBAN darin.
Ursache
Die Prüfung holte ihre Liste der Werte aus dem Tresor (Vault), also der Tabelle Platzhalter → Wert. Diese Tabelle füllt aber die Maskierungsfunktion selbst. Ein kaputter Maskierungsschritt lässt sie leer, die Prüfung hatte nichts zu suchen und bestand jedes Mal.
Die Lösung
Die Prüfung nimmt die Werte jetzt aus den Ergebnissen des Detektors, die nicht vom Maskierungsschritt abhängen. Meine Lehre daraus: Eine Sicherheitsprüfung darf ihre Eingaben nicht von dem bekommen, was sie prüft, und ein Test für eine Sicherheitsprüfung muss den geschützten Schritt absichtlich kaputt machen.
for value in vault.originals:
    if any(contains_value(m.content, value) for m in masked):
raise LeakCheckError("a masked value is still present in the outgoing text")for value in masked_values: # from the detector, before masking
if any(contains_value(m.content, value) for m in masked):
raise LeakCheckError("a masked value is still present in the outgoing text")Ergebnis
- 163 automatisierte Tests, darunter ein Round-Trip-Eigenschaftstest auf 500 zufälligen Texten: Kein maskierter Wert und kein Stück davon mit vier oder mehr Zeichen gelangt in die Eingabe des Modells.
- Dieser Eigenschaftstest hat vier der sechs Fehler gefunden, die ich behoben habe; die Tests mit von Hand gewählten Beispielen waren alle grün, obwohl diese Fehler noch im Code steckten.
- Das Maskieren der Beispiel-Kundennachricht dauert 0,4 ms (Median aus 200 Läufen), ein Text mit 16.700 Zeichen 22 ms.