PII Guard
Шлюз, который убирает персональные данные из запроса до того, как он попадёт в LLM, и возвращает их в ответ.
- Роль
- Личный проект — проектирование, код, тесты
- Год
- 2026
- Категория
- ИИ · Веб
- Стек
- Python 3.12, FastAPI, HTMX, Jinja2
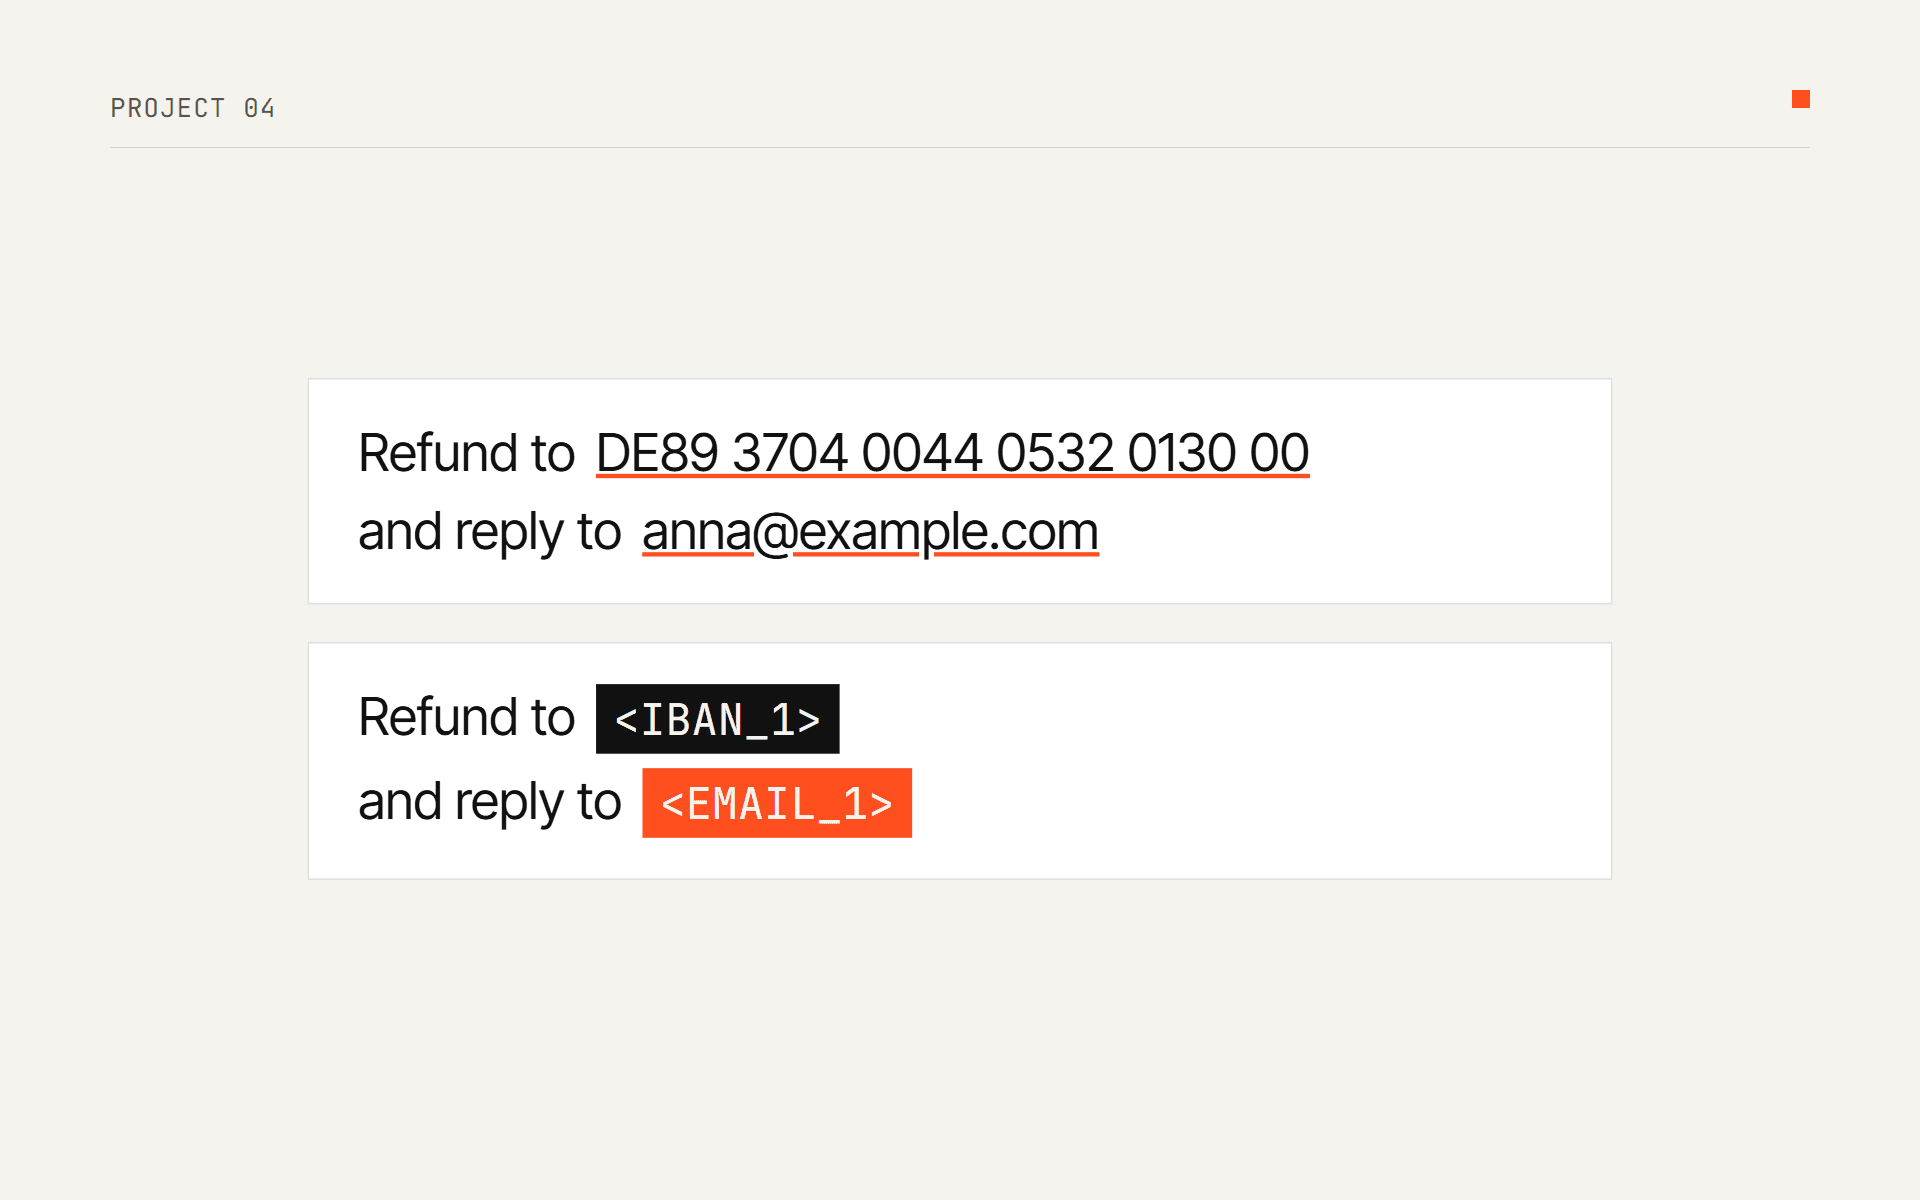
Проблема
Компании хотят, чтобы сотрудники пользовались LLM в повседневной работе с текстами: «напиши вежливый ответ этому клиенту», «объясни, что в этом логе». Такие тексты полны персональных данных — имён, адресов e-mail, телефонов, IBAN, — и всё это ушло бы стороннему провайдеру.
GDPR требует ограничивать персональные данные тем, что необходимо для цели. Чтобы написать ответ о возврате денег, модели не нужен настоящий IBAN. Ей нужно знать, что он есть и куда пойдут деньги. Мне было интересно, как далеко можно зайти с аккуратной проверкой данных без модели машинного обучения.
Решение
- Детекторы для e-mail, телефонов, IBAN, номеров карт, VAT ID стран ЕС, адресов IPv4 и дат рождения, у каждого настоящая проверка: mod-97 для IBAN, алгоритм Луна и префикс эмитента для карт, планы нумерации libphonenumber для телефонов, формат VIES для каждой страны для VAT ID.
- Каждое значение заменяется пронумерованным плейсхолдером (
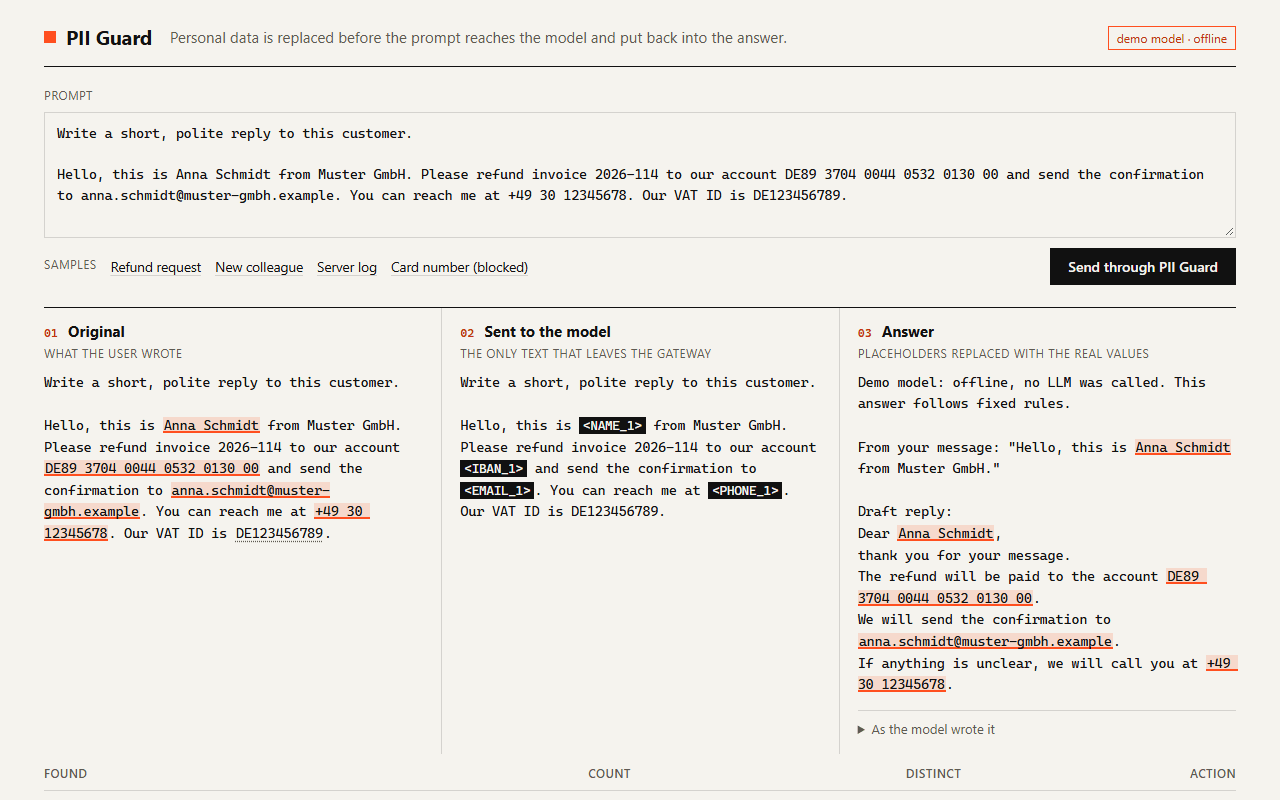
<EMAIL_1>,<IBAN_1>). Одно и то же значение всегда получает один и тот же плейсхолдер — во всём диалоге. - В модель уходит только замаскированный текст (Claude через Anthropic SDK или офлайн-демо-модель). Настоящие значения возвращаются в ответ, сколько бы раз модель ни повторила плейсхолдер.
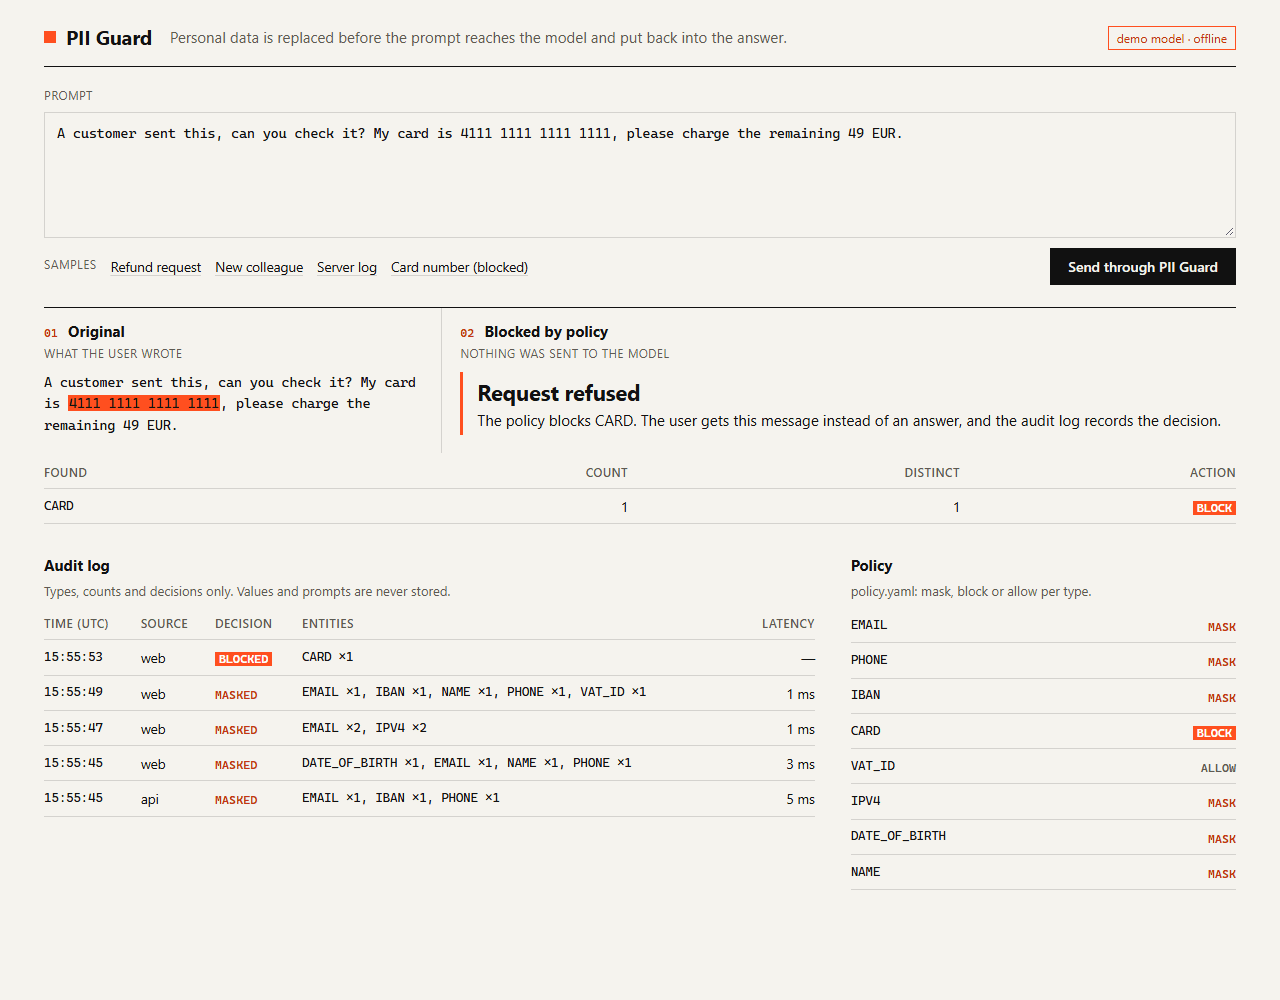
policy.yamlрешает для каждого типа: замаскировать, заблокировать весь запрос или пропустить. По умолчанию номер карты блокирует запрос.- Безопасный отказ (fail closed): перед отправкой в исходящем тексте ищется каждое значение, которое должно быть замаскировано. Если хоть одно осталось, запрос отклоняется.
- Журнал аудита в SQLite записывает время, решение, типы и количество найденных данных. В нём нет ни одного столбца, куда могло бы попасть значение.
- JSON API (
POST /v1/chat), веб-страница, на которой рядом видны оригинал, замаскированный текст и ответ, и CLI.
Скриншоты
Технологии
- Python 3.12
- FastAPI
- HTMX
- Jinja2
- Anthropic API
- phonenumbers
- SQLite
- pytest
Имена — честное слабое место: без NER-модели (torch и spaCy я сознательно не брал) находятся только имена из списка, например из выгрузки CRM. Телефоны проверяются по метаданным libphonenumber от Google, потому что планы нумерации в каждой стране свои и со временем меняются. Соответствие плейсхолдеров и значений живёт только в памяти и только на один запрос. Замаскированные запросы по GDPR всё равно остаются персональными данными (пункт 26 преамбулы), просто их меньше, поэтому README описывает, что делает инструмент, и не обещает никому «соответствия GDPR».
Фрагмент кода
«Настоящая проверка» означает, что кандидат должен пройти правило из стандарта, а не просто быть похожим. Для IBAN это ISO 13616: длина, зарегистрированная для страны, контрольные цифры от 02 до 98 и остаток 1 при делении на 97:
def iban_is_valid(value: str) -> bool:
    iban = compact(value)
    if not _IBAN_CHARS.fullmatch(iban):
        return False
    if IBAN_LENGTHS.get(iban[:2]) != len(iban):
        return False
    if not 2 <= int(iban[2:4]) <= 98:
        return False
    # Move country code and check digits to the end, then A=10 ... Z=35.
    rearranged = iban[4:] + iban[:4]
    number = "".join(str(int(char, 36)) for char in rearranged)
    return int(number) % 97 == 1
Баг, который я нашёл и исправил
Проверка на утечку доверяла шагу, который она проверяет
Что сломалось
После маскировки шлюз ищет в исходящем тексте каждое значение, которого там быть не должно, и отклоняет запрос, если оно осталось. Я написал тест, который подменяет функцию маскировки сломанной — она возвращает текст без изменений. Тест ждал, что запрос будет отклонён. Запрос прошёл, с настоящим IBAN внутри.
Причина
Проверка брала список значений из хранилища (vault) — таблицы «плейсхолдер → значение». Но это хранилище заполняет сама функция маскировки. Сломанная маскировка оставляет его пустым, поэтому проверке нечего было искать, и она проходила каждый раз.
Исправление
Теперь проверка берёт значения из результатов детектора, которые от маскировки не зависят. Вывод, который я для себя сделал: защитная проверка не должна получать данные от того, что она проверяет, а тест защитной проверки должен нарочно ломать защищаемый шаг.
for value in vault.originals:
    if any(contains_value(m.content, value) for m in masked):
raise LeakCheckError("a masked value is still present in the outgoing text")for value in masked_values: # from the detector, before masking
if any(contains_value(m.content, value) for m in masked):
raise LeakCheckError("a masked value is still present in the outgoing text")Результат
- 163 автоматических теста, среди них тест свойства «туда и обратно» на 500 случайных текстах: ни одно замаскированное значение и ни один его кусок длиной от четырёх символов не попадают на вход модели.
- Этот тест свойства нашёл четыре из шести исправленных багов; тесты с примерами, подобранными вручную, проходили, хотя эти баги были в коде.
- Маскировка примера сообщения клиента занимает 0,4 мс (медиана 200 запусков), текста из 16 700 символов — 22 мс.