E-Invoice
Macht aus einer PDF-Rechnung eine XRechnung und erklärt Regel für Regel, was daran nicht stimmt.
- Rolle
- Eigenes Projekt — Konzept, Code, Tests
- Jahr
- 2026
- Kategorie
- KI · Web
- Technologien
- Python 3.12, FastAPI, Jinja2, Anthropic API
Das Problem
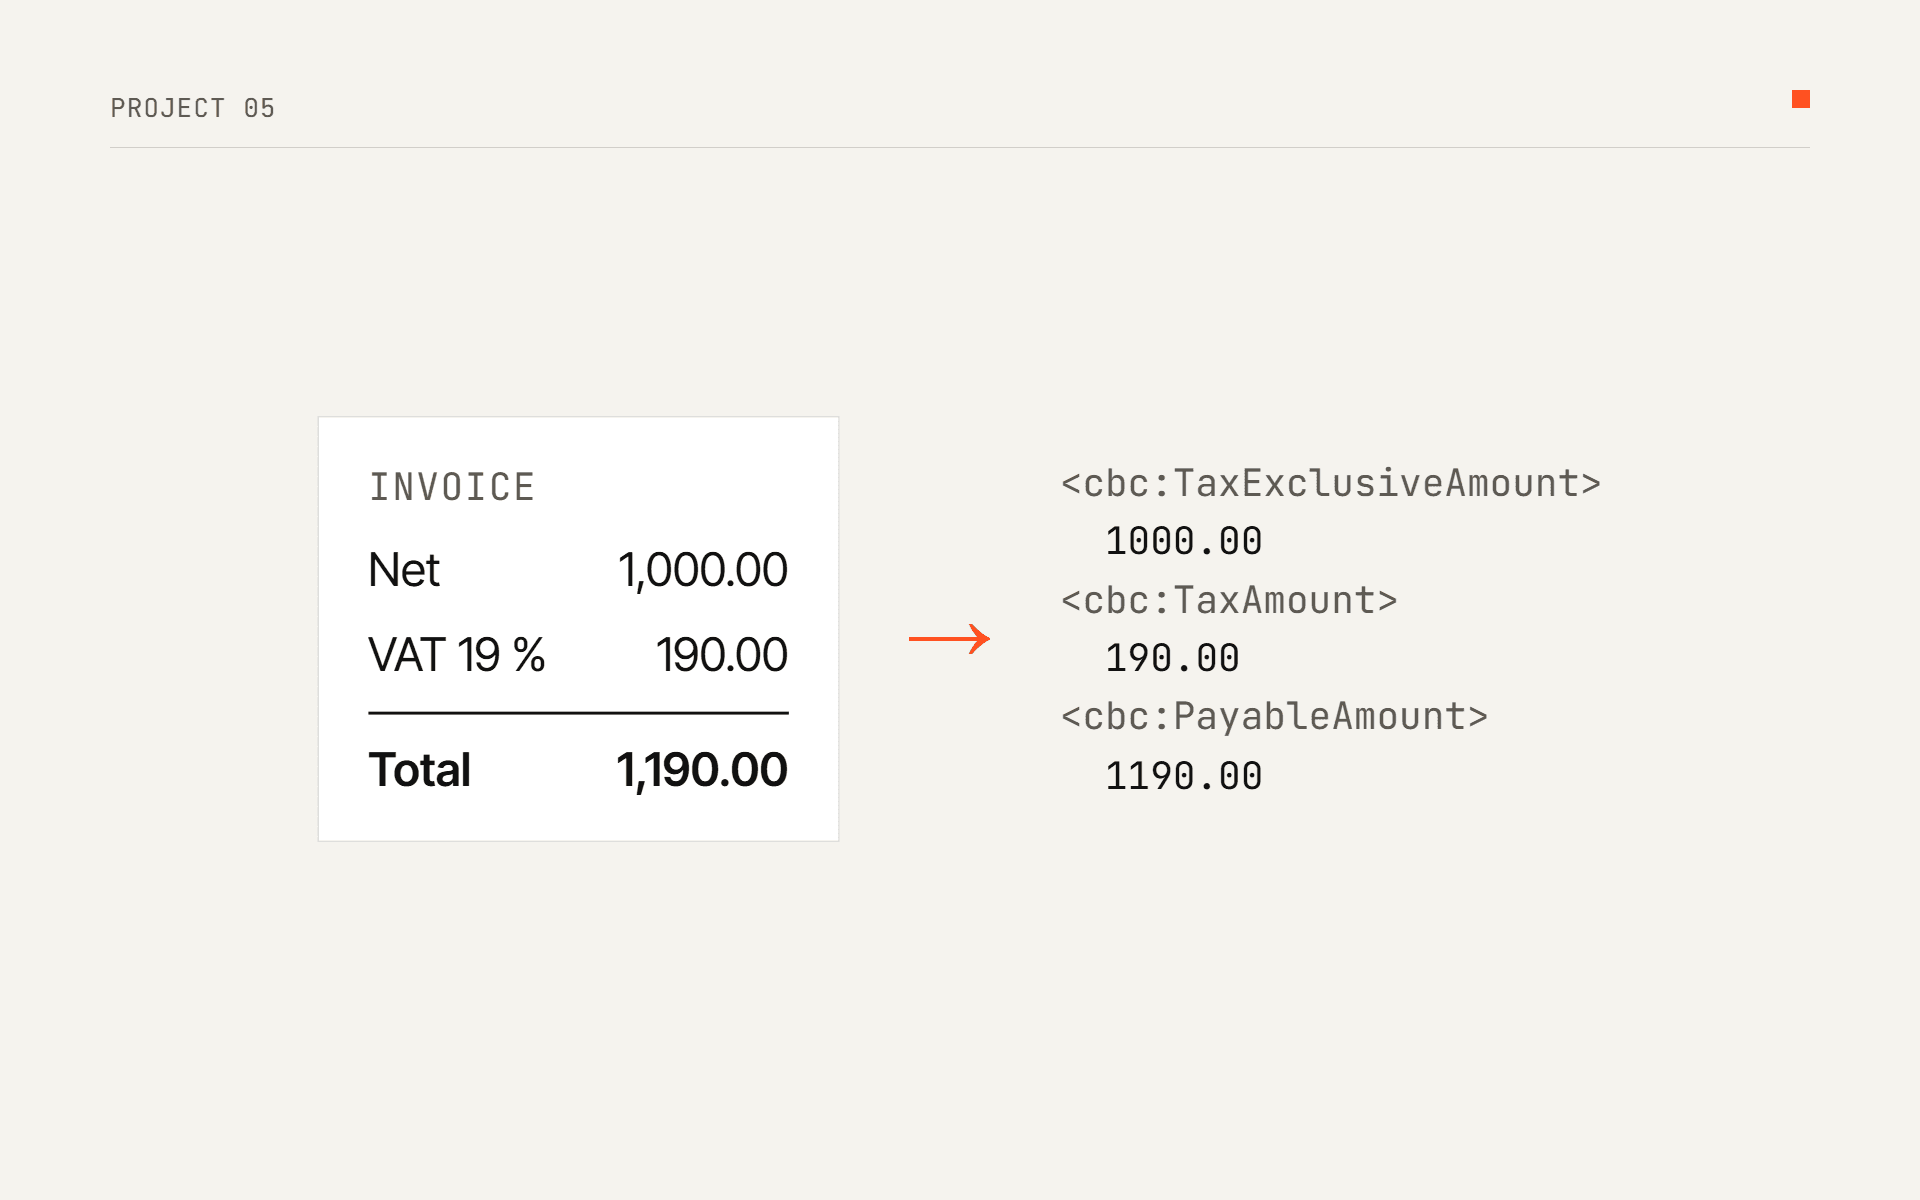
Seit dem 1. Januar 2025 müssen Rechnungen zwischen Unternehmen in Deutschland E-Rechnungen sein: ein strukturiertes Format nach der europäischen Norm EN 16931, kein PDF. Papier und PDF sind noch bis zum 31. Dezember 2026 erlaubt, für Unternehmen mit einem Vorjahresumsatz von höchstens 800.000 Euro bis zum 31. Dezember 2027. Für den Empfang gibt es keine Übergangsfrist: Seit dem
- Januar 2025 muss jedes Unternehmen E-Rechnungen empfangen können.
Viele kleine Firmen schreiben Rechnungen noch in Word und verschicken PDFs. Ein PDF kann für Menschen richtig aussehen und für eine Maschine trotzdem falsch sein: Summen, die nicht aufgehen, eine fehlende Käuferreferenz, ein Tippfehler in der IBAN. Ich möchte in Europa arbeiten, und in Deutschland geht gerade jedes Unternehmen durch diese Umstellung. Deshalb habe ich den Konverter gebaut, den ich mir als Buchhalter selbst wünschen würde.
Die Lösung
- Die Textebene des PDFs wird aus den Wortpositionen wieder zu Zeilen und Tabellenzellen zusammengesetzt, damit eine Tabellenzeile eine Zeile bleibt.
- Claude liest die Rechnung in ein festes JSON-Schema (Structured Output). Die Anweisung lautet, das Gedruckte zu übernehmen und keine Zahlen zu korrigieren: Eine „korrigierte“ Summe würde genau den Fehler verstecken, den der Validator finden soll.
- Ohne API-Schlüssel liest ein regelbasierter Extraktor die mitgelieferten deutschen und englischen Layouts offline (Demo-Modus).
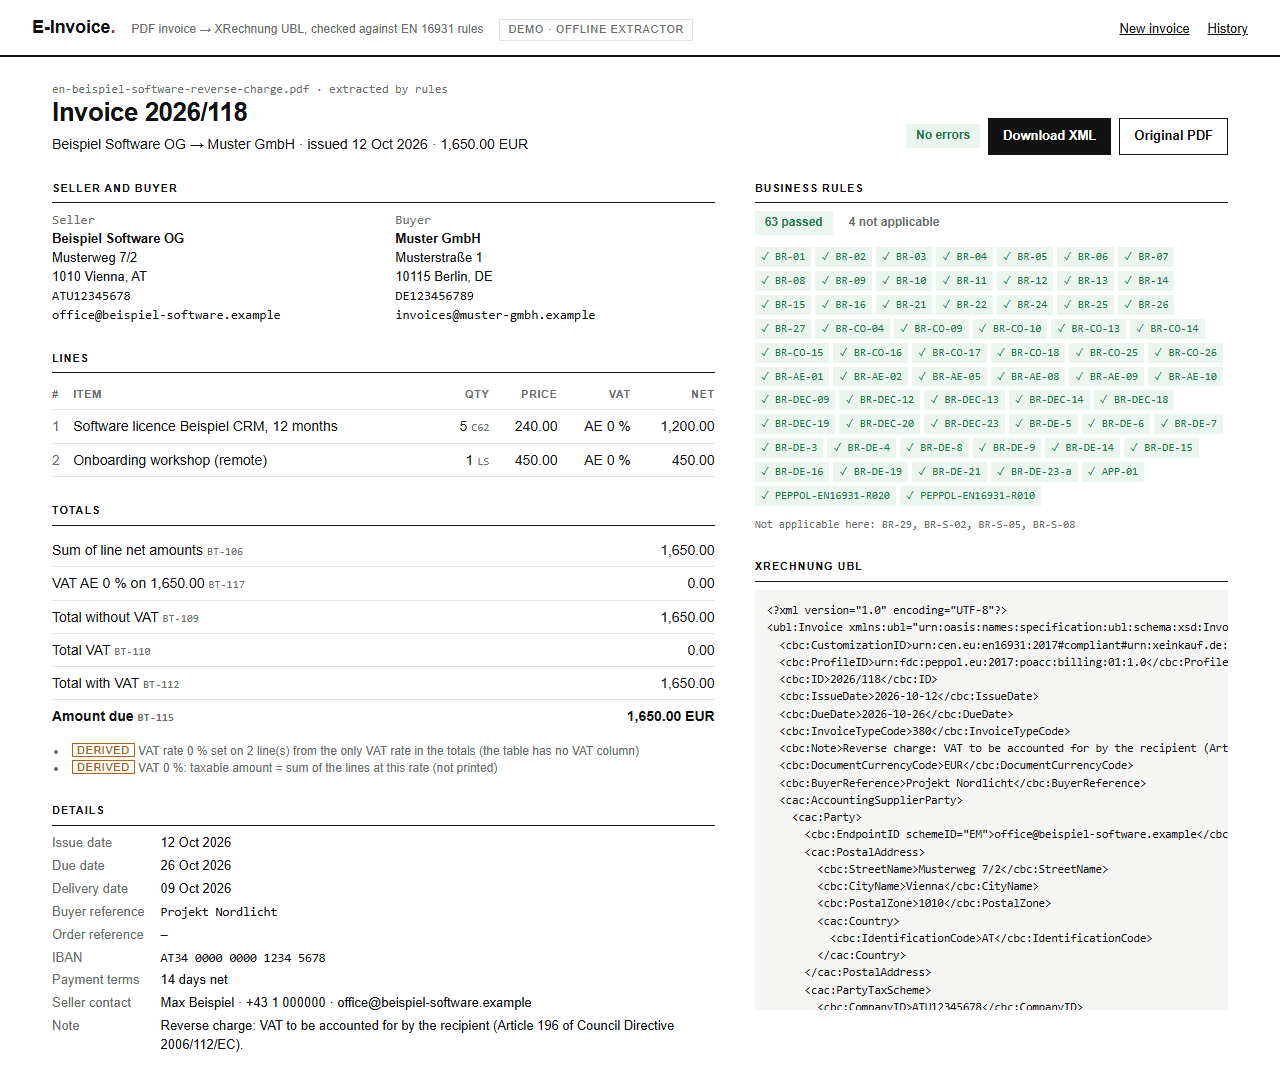
- Werte, die nicht im PDF stehen, die die Norm aber verlangt, werden berechnet und als „derived“ markiert, damit „berechnet“ nie mit „geprüft“ verwechselt wird.
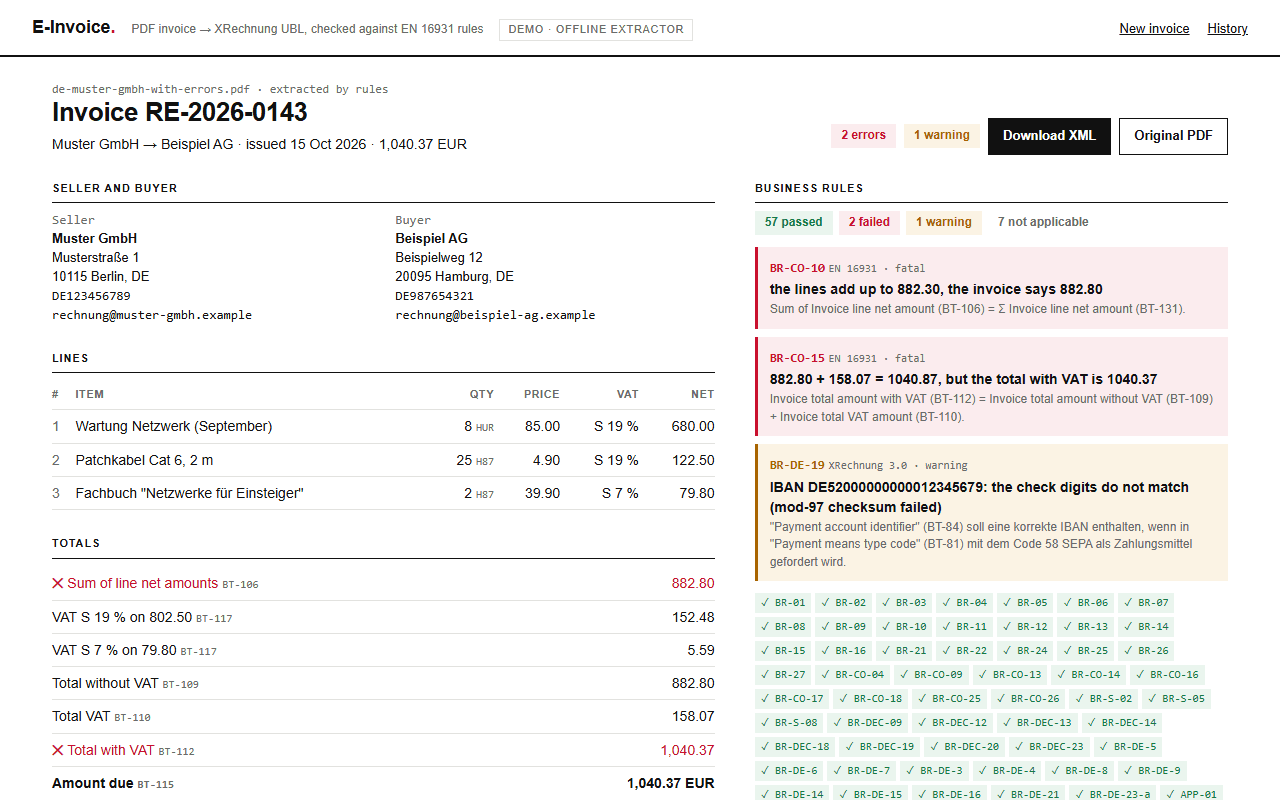
- 67 Geschäftsregeln mit ihren offiziellen IDs: 51 aus EN 16931, 15 aus XRechnung und eine eigene. Jede verletzte Regel zeigt ihre ID und die Zahlen: „BR-CO-10: the lines add up to 882.30, the invoice says 882.80“.
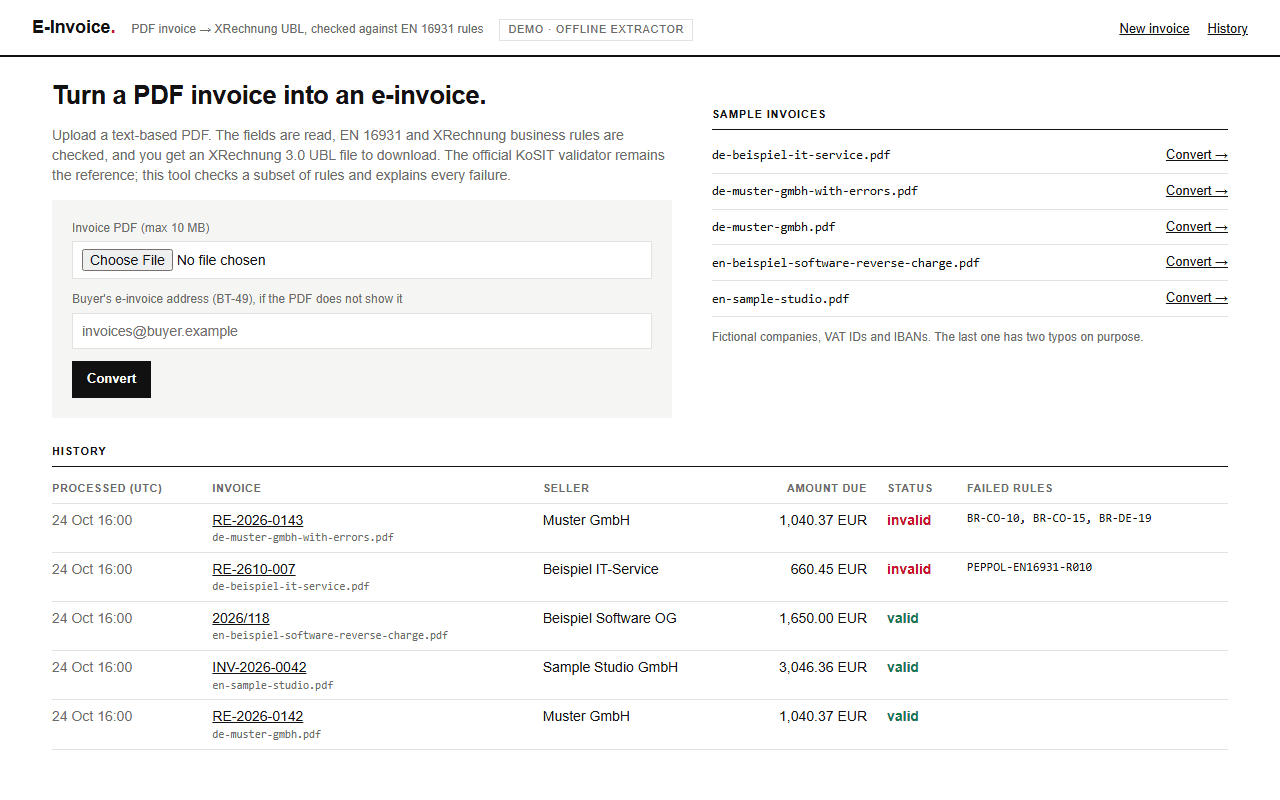
- Das Ergebnis ist eine XRechnung-3.0-Datei in UBL 2.1 zum Herunterladen, aus der Web-App oder über die Kommandozeile. Ein Verlauf in SQLite speichert jede Rechnung mit Status und XML.
Screenshots
Technologien
- Python 3.12
- FastAPI
- Jinja2
- Anthropic API
- pdfplumber
- lxml
- SQLite
- pytest
Geld ist überall Decimal und wird kaufmännisch gerundet (halbe Cent nach oben), wie
XPath-round() in den offiziellen Regeln; Pythons round() rundet 0,125 auf 0,12. Das LLM-Schema liefert Beträge als
Text, sodass sie nie durch einen Float laufen. Die Referenz ist der offizielle KoSIT-Validator
(Java). Um zu sehen, wie nah meine Teilmenge der Regeln daran ist, lässt ein Skript das offizielle
UBL-Schema, das CEN-EN-16931-Schematron und das KoSIT-XRechnung-Schematron über das XML jedes
Beispiels laufen.
Code im Detail
Jede Regel ist eine kleine Funktion, die mit ihrer offiziellen ID und ihrem Text registriert
wird. Sie gibt None zurück, wenn die Rechnung die Prüfung besteht, sonst einen Satz mit den
tatsächlichen Zahlen. Ein Test bricht jede Regel absichtlich, und ein weiterer Test schlägt fehl,
wenn eine neue Regel keinen solchen Fall hat:
@rule(
    "BR-CO-15",
    "Invoice total amount with VAT (BT-112) = Invoice total amount without VAT (BT-109) + "
    "Invoice total VAT amount (BT-110).",
)
def br_co_15(inv: Invoice) -> str | None:
    t = inv.totals
    if t.tax_inclusive is None or t.tax_exclusive is None or t.vat_total is None:
        raise NotApplicable
    expected = _xpath_round(t.tax_exclusive + t.vat_total)
    if t.tax_inclusive == expected:
        return None
    return (
        f"{t.tax_exclusive:f} + {t.vat_total:f} = {expected:f}, "
        f"but the total with VAT is {t.tax_inclusive:f}"
    )
Ein Fehler, den ich gefunden und behoben habe
Meine Regel BR-CO-13 meldete einen Fehler, den die offiziellen Regeln nicht melden
Was kaputt war
Beim Beispiel mit falscher Zwischensumme (die Positionen ergeben 882,30, im PDF steht 882,80) meldete mein Validator drei Fehler. Das offizielle CEN-Schematron meldete auf demselben XML zwei: BR-CO-10 und BR-CO-15, aber nicht BR-CO-13.
Ursache
Ich hatte BR-CO-13 nach dem Regeltext umgesetzt: „Gesamtbetrag ohne Umsatzsteuer = Σ Nettobeträge der Positionen − Nachlässe + Zuschläge“. Der offizielle Test summiert die Positionen nicht. Ohne Nachlässe und Zuschläge vergleicht er den Betrag ohne Umsatzsteuer (BT-109) mit der auf der Rechnung gedruckten Positionssumme (BT-106). Die Positionen gegen BT-106 zu prüfen ist Aufgabe von BR-CO-10. Ein Tippfehler stand dadurch zweimal im Bericht, und mein Bericht stimmte nicht mit dem überein, was der Validator beim Käufer sagen würde.
Die Lösung
Ich folge jetzt dem Test aus dem Schematron, und ein Regressionstest sorgt dafür, dass es so bleibt. Seitdem lese ich bei jeder Rechenregel den offiziellen Test, nicht nur den einzeiligen Text. Bei allen fünf Beispielen melden mein Validator und das offizielle Schematron jetzt genau dieselben Regel-IDs.
expected = _xpath_round(_sum(line.net_amount for line in inv.lines))
if inv.totals.tax_exclusive == expected:
return None# The official schematron compares BT-109 with BT-106 (LineExtensionAmount), not with the
# sum of the lines: that sum is BR-CO-10's job.
if t.tax_exclusive == t.line_net_total:
return NoneErgebnis
- 192 automatisierte Tests: Extraktion auf jedem Beispiellayout, jede der 67 Regeln erfüllt und verletzt,
Decimal-Rundung, das XML Element für Element zurückgelesen, die Web-App und die Kommandozeile. - Bei allen fünf Beispielen melden das offizielle CEN- und KoSIT-Schematron genau dieselben Regel-IDs wie mein Validator, und jede XML-Datei ist gültig gegen das UBL-2.1-Schema.
- Die Offline-Konvertierung eines Beispiels (lesen, extrahieren, 67 Regeln, XML) dauert 16–29 ms.