Accessibility Check
Обходит небольшой сайт, проверяет его HTML по WCAG 2.2 и простыми словами объясняет, что исправить.
- Роль
- Личный проект — проектирование, код, тесты
- Год
- 2026
- Категория
- Веб
- Стек
- Python 3.12, asyncio, httpx, FastAPI
Проблема
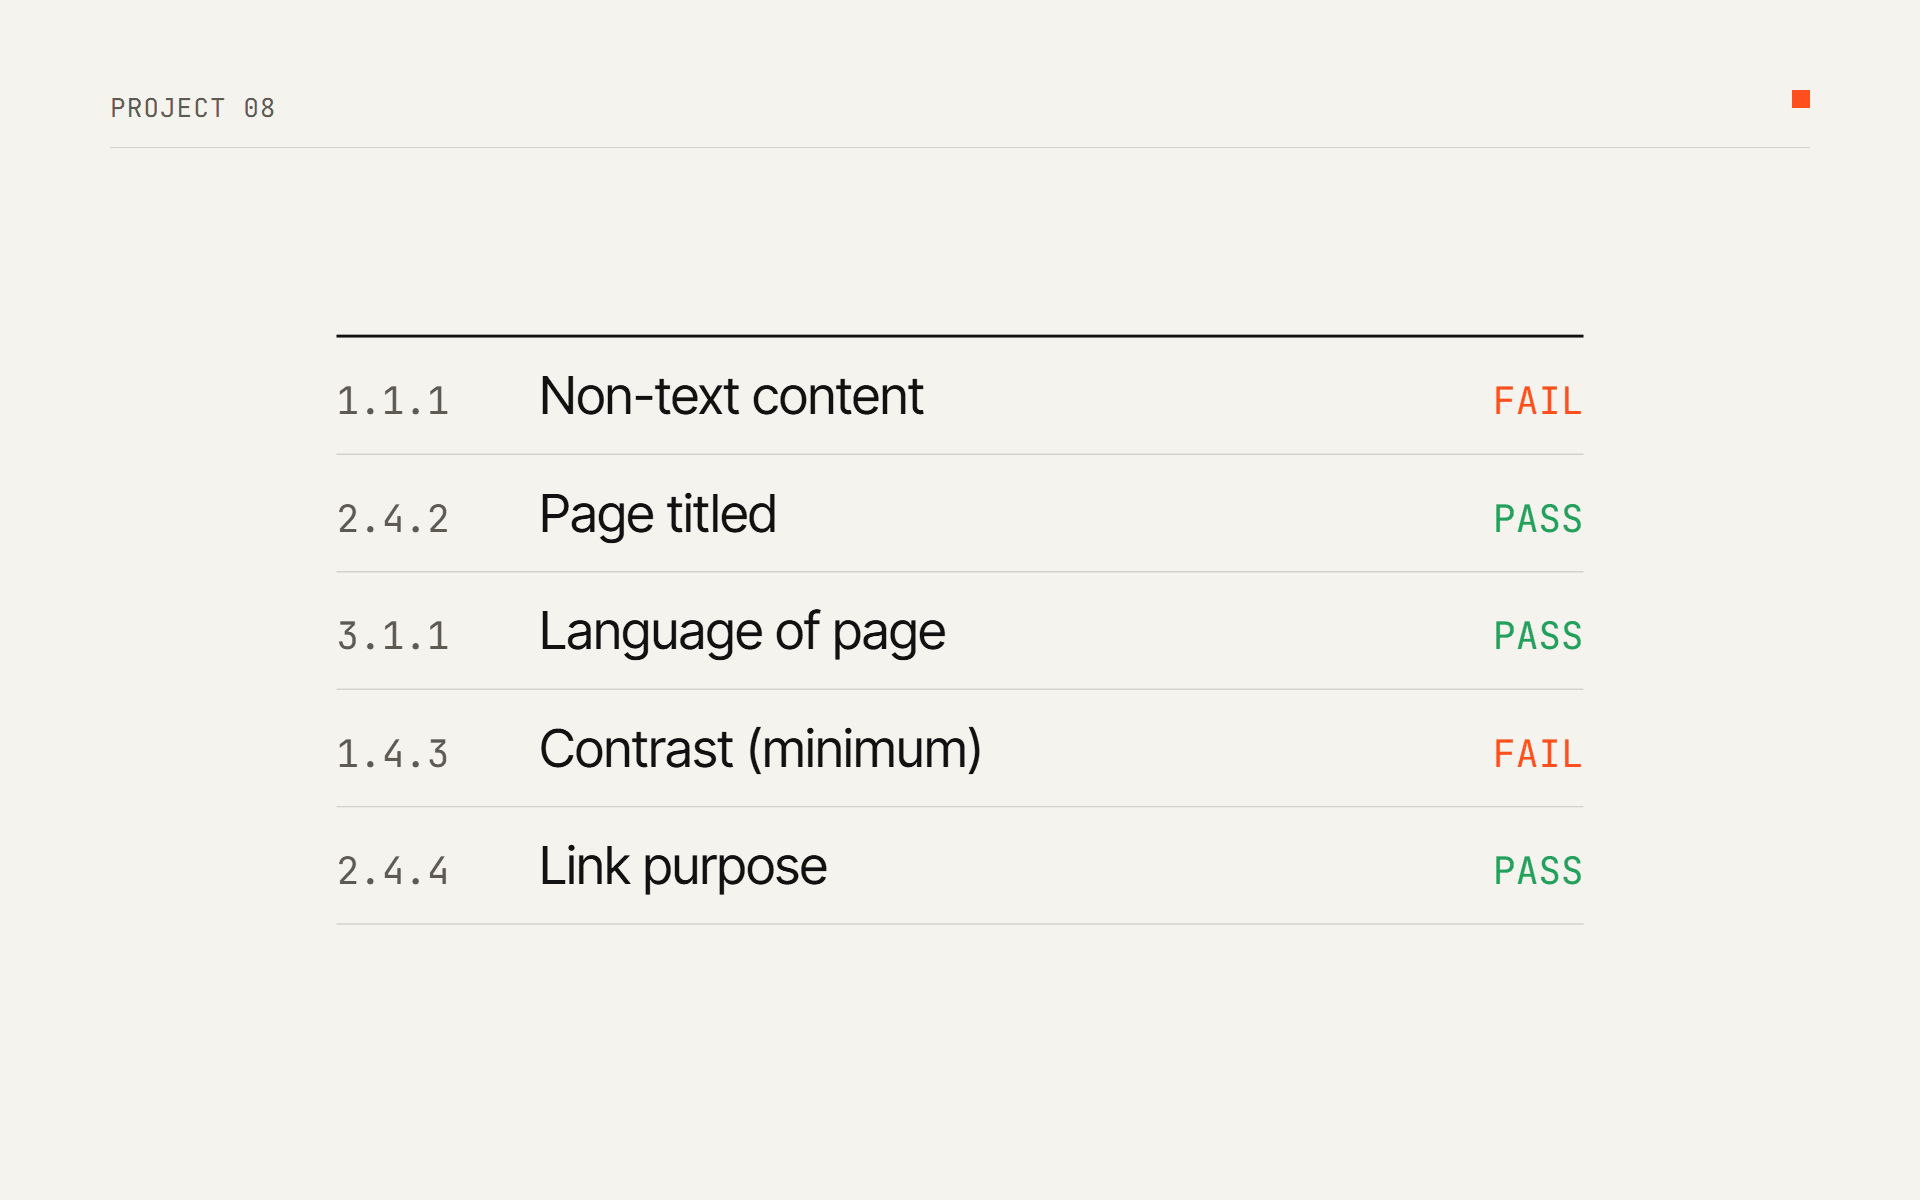
С 28 июня 2025 года Европейский акт о доступности (Директива (ЕС) 2019/882) действует для многих услуг, которые продают потребителям в ЕС, в том числе для интернет-магазинов. Сайты должны быть «воспринимаемыми, управляемыми, понятными и надёжными», а европейский стандарт EN 301 549 теперь отсылает за подробностями к WCAG 2.2. Совсем маленькие компании, оказывающие услуги (меньше 10 человек), освобождены, но многие интернет-магазины — нет.
Владелец такого бизнеса обычно не знает, в каком состоянии его сайт. Профессиональный аудит стоит денег, а инструменты вроде axe проверяют по одной странице и говорят языком разработчика. Мне хотелось первого отчёта, который владелец магазина сможет прочитать и передать своему веб-разработчику: что не так, на какой странице и что поменять.
Решение
- Вводишь адрес сайта. Вежливый краулер читает до 20 страниц этого же сайта, соблюдает robots.txt и делает паузу в полсекунды после каждого запроса.
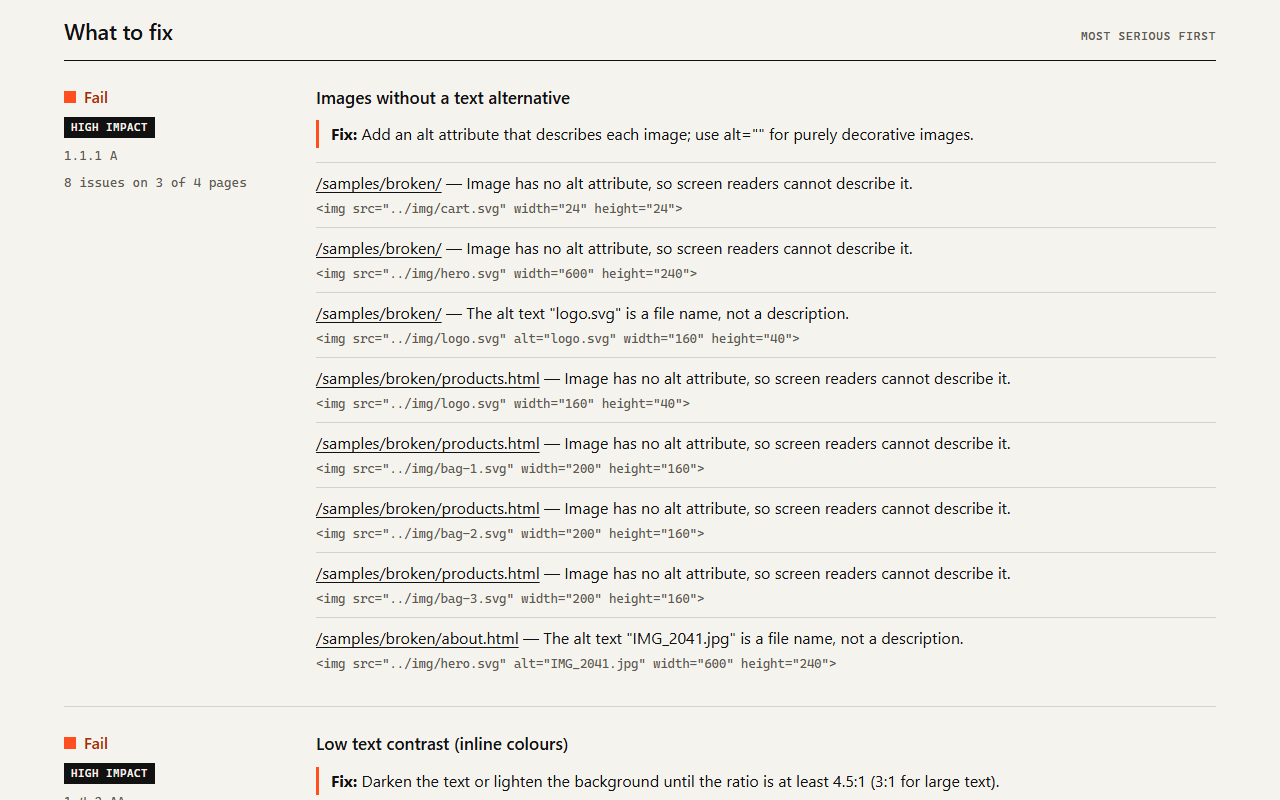
- На HTML каждой страницы запускаются 17 проверок: изображения без alt, поля без подписей, отсутствующие заголовок страницы и язык, ссылки-иконки и кнопки без текста, запрет масштабирования, фреймы без названия, автозапуск медиа и контраст текста там, где оба цвета записаны прямо в HTML.
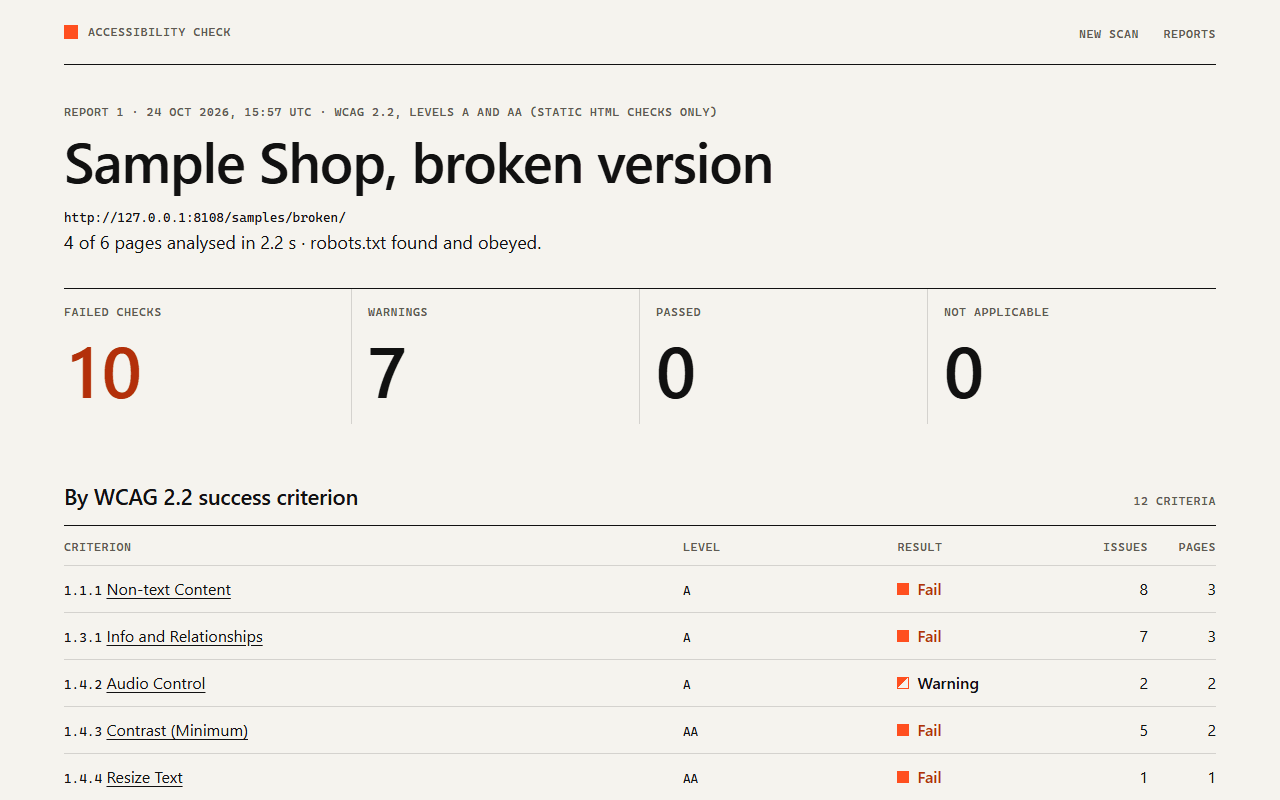
- Каждая находка привязана к критерию успеха WCAG 2.2 с его уровнем, и у неё есть исправление в одну строку и HTML-фрагмент, который её вызвал.
- Отчёт показывает результат по критериям, по правилам и по страницам, его можно скачать одним HTML-файлом или в JSON. Отчёты хранятся в SQLite.
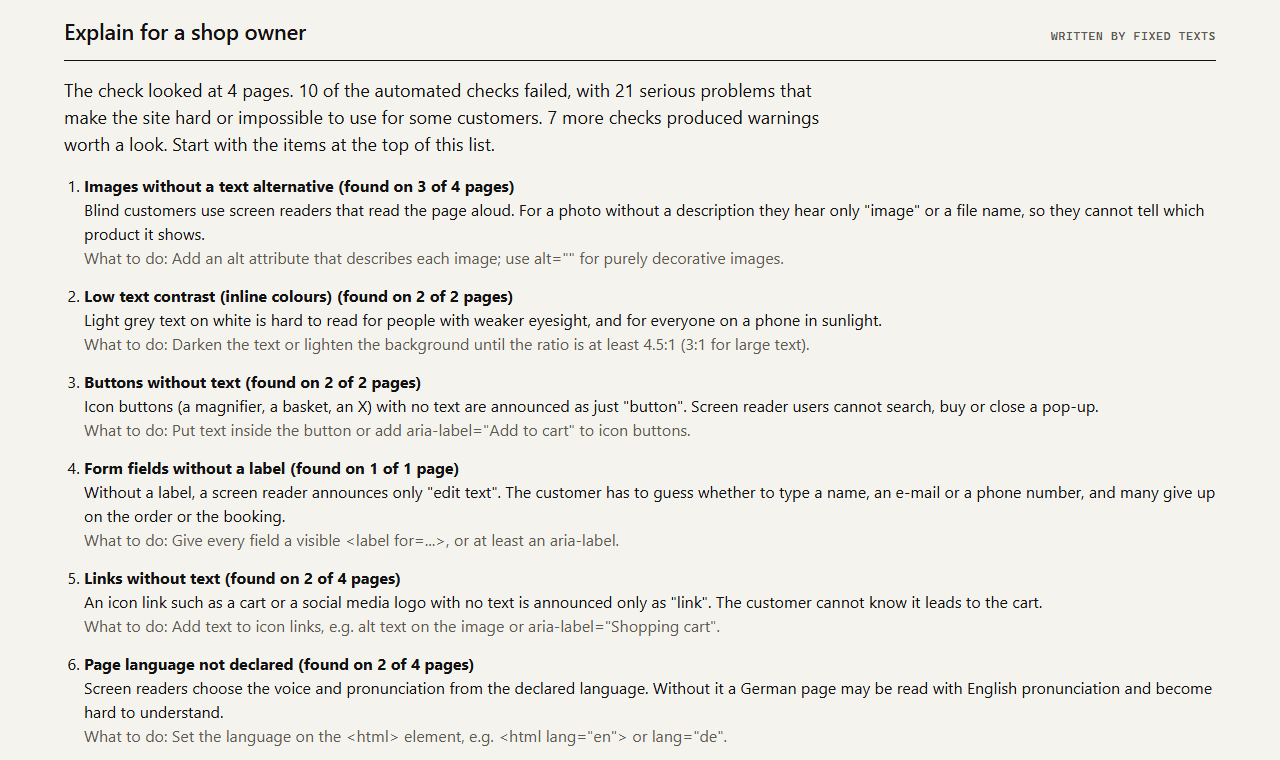
- Кнопка «Explain for a shop owner» пишет объяснение простыми словами: из готовых текстов офлайн или через Claude на английском, немецком, русском или турецком.
- Отчёт прямо говорит, что он не может проверить: цвета после отрисовки, работу с клавиатуры, порядок фокуса и реальное поведение экранного диктора — это нужно проверять вручную.
Скриншоты
Технологии
- Python 3.12
- asyncio
- httpx
- FastAPI
- Jinja2
- BeautifulSoup
- lxml
- SQLite
- Anthropic API
- pytest
- Docker
Краулер построен на httpx и asyncio: два обработчика, лимит страниц и пауза после каждого
запроса. robots.txt читает мой собственный парсер по RFC 9309, потому что встроенный в Python
применяет первое подходящее правило вместо самого длинного и не понимает шаблон *. HTML
разбирается BeautifulSoup с lxml. Адреса, которые ведут во внутренние сети, отклоняются, поэтому
публичную копию инструмента нельзя использовать, чтобы прощупать сеть сервера.
Фрагмент кода
Проверка контраста использует формулы WCAG 2.2 напрямую. #777 на белом даёт 4.48:1 — чуть меньше
4.5:1, которые нужны тексту обычного размера:
def _channel(value_8bit: int) -> float:
    c = value_8bit / 255
    return c / 12.92 if c <= 0.04045 else ((c + 0.055) / 1.055) ** 2.4


def relative_luminance(color: RGBA) -> float:
    return 0.2126 * _channel(color.r) + 0.7152 * _channel(color.g) + 0.0722 * _channel(color.b)


def contrast_ratio(a: RGBA, b: RGBA) -> float:
    la, lb = relative_luminance(a), relative_luminance(b)
    lighter, darker = max(la, lb), min(la, lb)
    return (lighter + 0.05) / (darker + 0.05)
Баг, который я нашёл и исправил
Главная страница анализировалась дважды, и её проблемы считались два раза
Что сломалось
Первая проверка моего «сломанного» учебного магазина показала запрет масштабирования «на 2 страницах» и проблему с языком на 3 страницах. Ошибку с масштабом я заложил только на главную, а ошибку с языком — на две страницы, так что цифры были неверными.
Причина
Обход начинается с /samples/broken/, а меню ссылается на index.html. Сервер отдаёт по обоим
адресам один и тот же документ. По одним только URL краулер не может понять, что это одна
страница, поэтому проанализировал главную дважды и посчитал каждую её проблему два раза.
Исправление
Теперь краулер считает хеш HTML каждой страницы. Страница с точно таким же HTML, как у уже проверенной, остаётся в списке со своим кодом ответа, помечается как дубликат и больше не анализируется и не обходится. Та же проверка теперь показывает 4 проанализированные страницы и правильные цифры, а тест фиксирует точное число находок по каждому правилу.
if page.final_url != page.url and page.final_url in self._final_urls:
    page.error = page.error or f"Redirects to {page.final_url}, which is already scanned"
    page.soup = None
self._final_urls.add(page.final_url)if page.final_url != page.url and page.final_url in self._final_urls:
page.duplicate_of = self._final_urls[page.final_url]
elif page.body_hash and page.body_hash in self._hashes:
page.duplicate_of = self._hashes[page.body_hash]
if page.duplicate_of:
page.soup = None # same document: do not analyse it or follow its links again
else:
self._final_urls.setdefault(page.final_url, page.url)
if page.body_hash:
self._hashes[page.body_hash] = page.urlРезультат
- 208 автоматических тестов (110 тестовых функций): каждое правило на проходящем и непроходящем HTML, расчёт контраста на известных значениях и краулер на поддельных сайтах (robots.txt, лимит страниц, редиректы, параллельность).
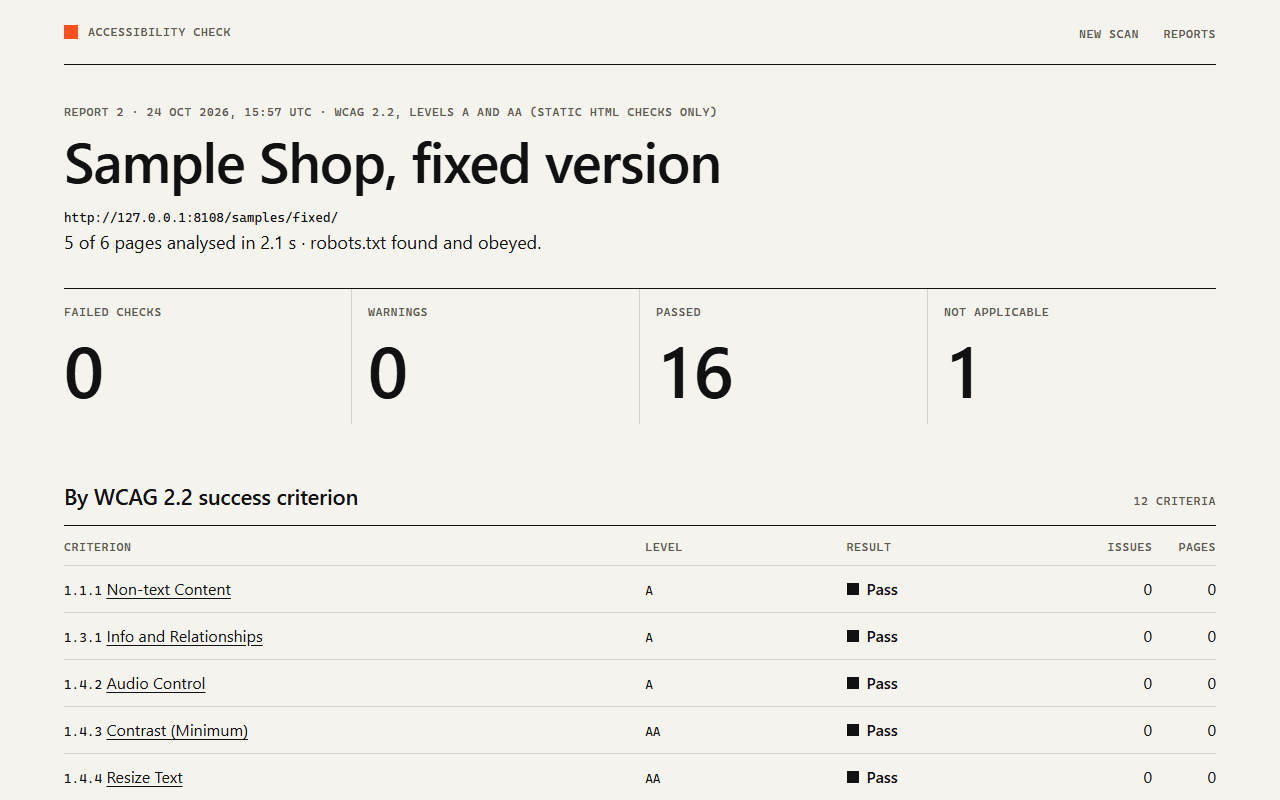
- «Сломанный» учебный магазин: 10 проваленных проверок и 7 предупреждений на 4 страницах. Исправленная версия: 16 проверок пройдено, 0 провалено. Каждая проверка занимает около 2 секунд вместе с вежливыми паузами.
- Настоящая проверка моего сайта-портфолио: 15 страниц за 7,5 секунды, 0 проваленных проверок, 13 пройдено, 4 неприменимы (нет форм, цветов в разметке и фреймов).