Accessibility Check
Durchsucht eine kleine Website, prüft ihr HTML nach WCAG 2.2 und erklärt in einfachen Worten, was zu beheben ist.
- Rolle
- Eigenes Projekt — Konzept, Code, Tests
- Jahr
- 2026
- Kategorie
- Web
- Technologien
- Python 3.12, asyncio, httpx, FastAPI
Das Problem
Seit dem 28. Juni 2025 gilt der European Accessibility Act (Richtlinie (EU) 2019/882) für viele Dienstleistungen, die an Verbraucher in der EU verkauft werden, darunter Onlineshops. Websites müssen „wahrnehmbar, bedienbar, verständlich und robust“ sein, und die europäische Norm EN 301 549 verweist für die Einzelheiten inzwischen auf WCAG 2.2. Sehr kleine Dienstleister (weniger als 10 Beschäftigte) sind ausgenommen, viele Onlineshops aber nicht.
Die Inhaber solcher Betriebe wissen meist nicht, wo ihre Website steht. Ein professionelles Audit kostet Geld, und Werkzeuge wie axe prüfen jeweils eine Seite und sprechen die Sprache von Entwicklern. Ich wollte einen ersten Bericht, den ein Shop-Inhaber lesen und an seinen Webentwickler weitergeben kann: was nicht stimmt, auf welcher Seite und was zu ändern ist.
Die Lösung
- Man gibt die Adresse der Website ein. Ein höflicher Crawler liest bis zu 20 Seiten derselben Website, hält sich an robots.txt und wartet nach jeder Anfrage eine halbe Sekunde.
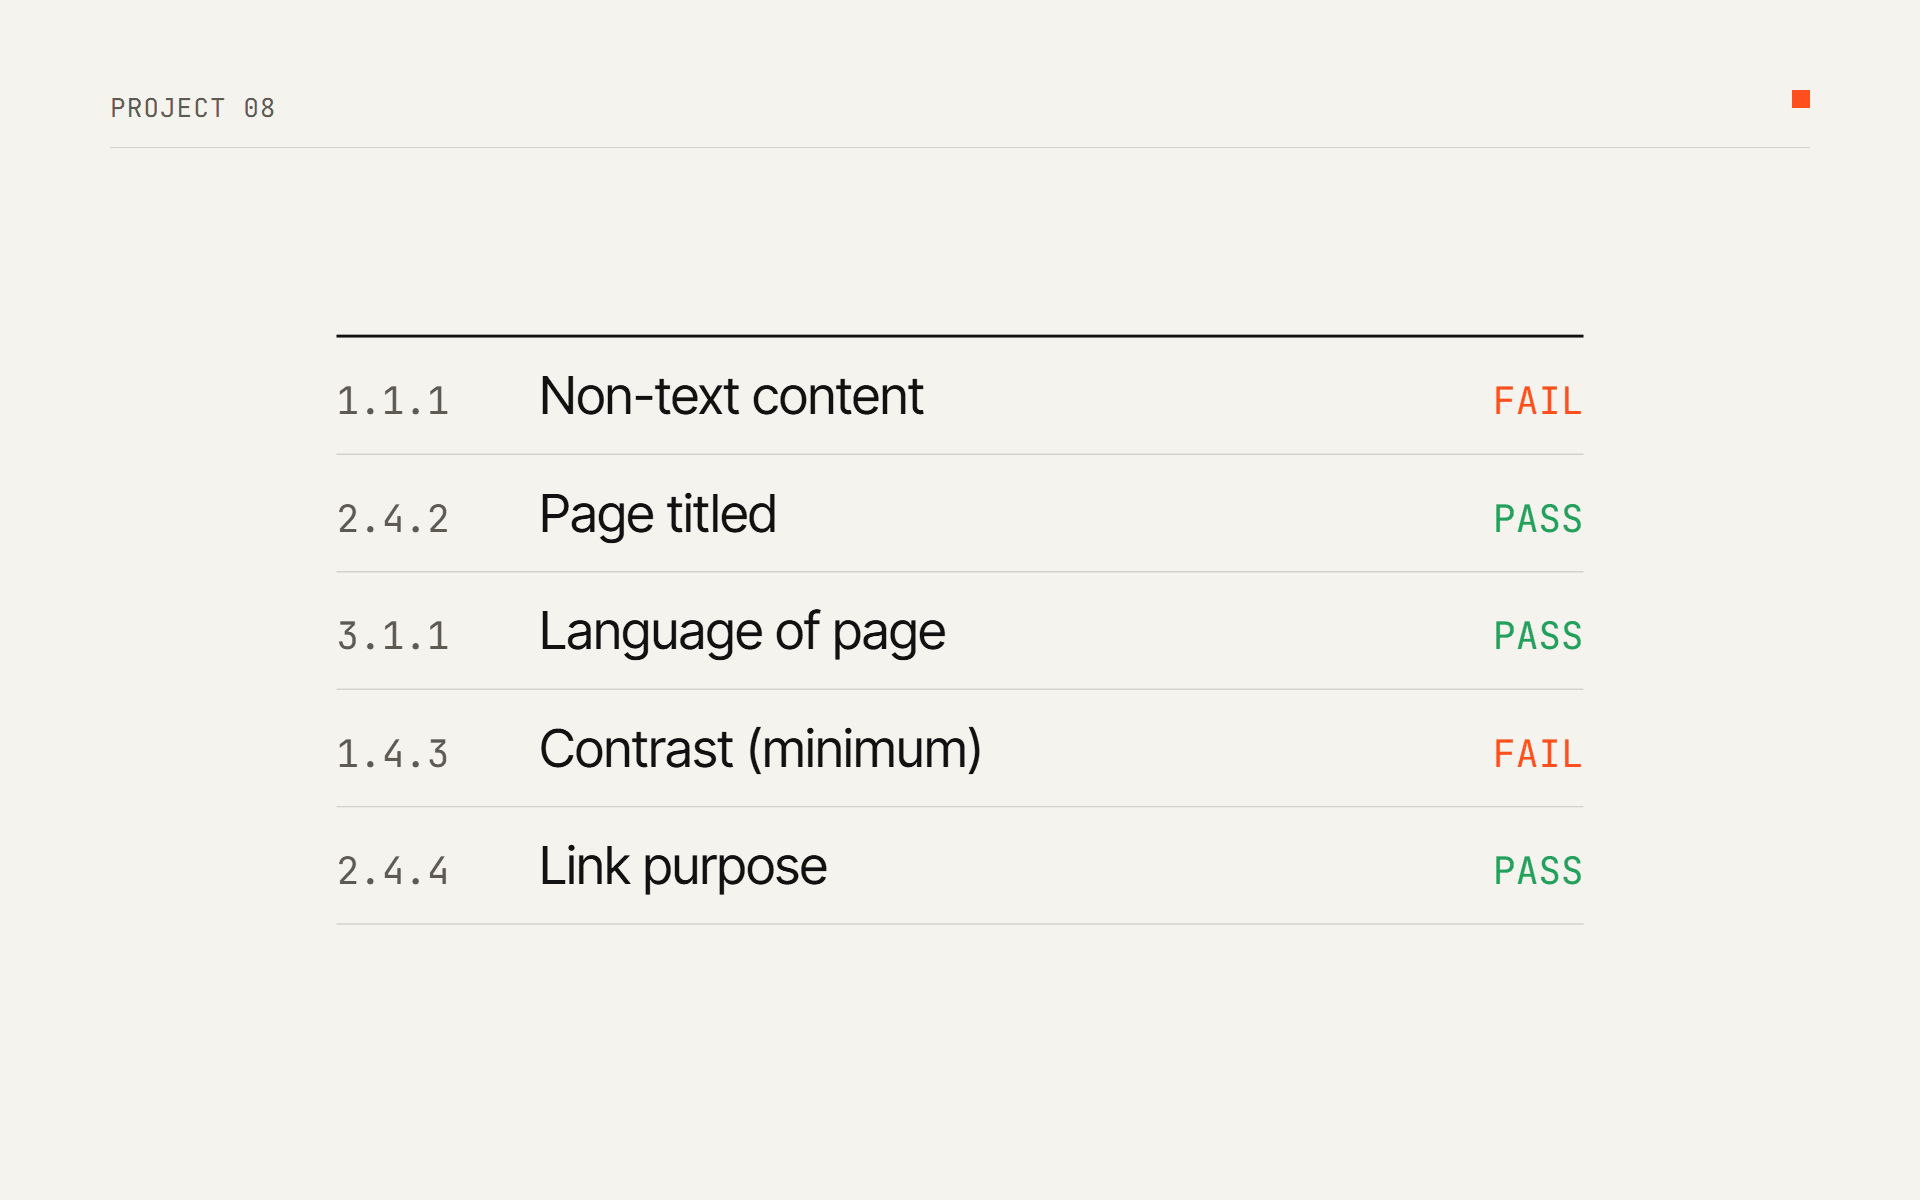
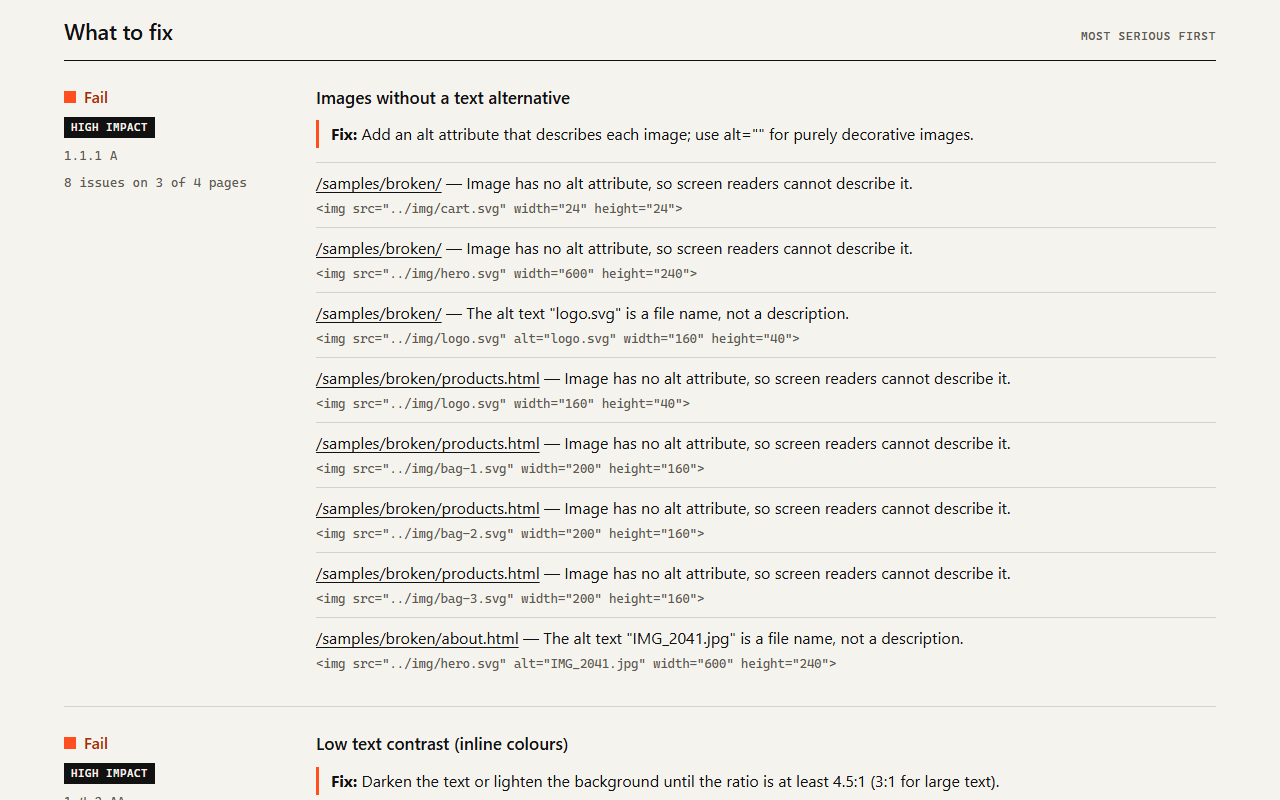
- Auf dem HTML jeder Seite laufen 17 Prüfungen: Bilder ohne Alt-Text, Formularfelder ohne Beschriftung, fehlender Seitentitel und fehlende Sprachangabe, Icon-Links und Buttons ohne Text, gesperrter Zoom, Frames ohne Titel, automatisch abgespielte Medien und Farbkontrast dort, wo beide Farben direkt im HTML stehen.
- Jeder Befund ist einem WCAG-2.2-Erfolgskriterium mit seiner Stufe zugeordnet und hat eine einzeilige Korrektur und den HTML-Ausschnitt, der ihn ausgelöst hat.
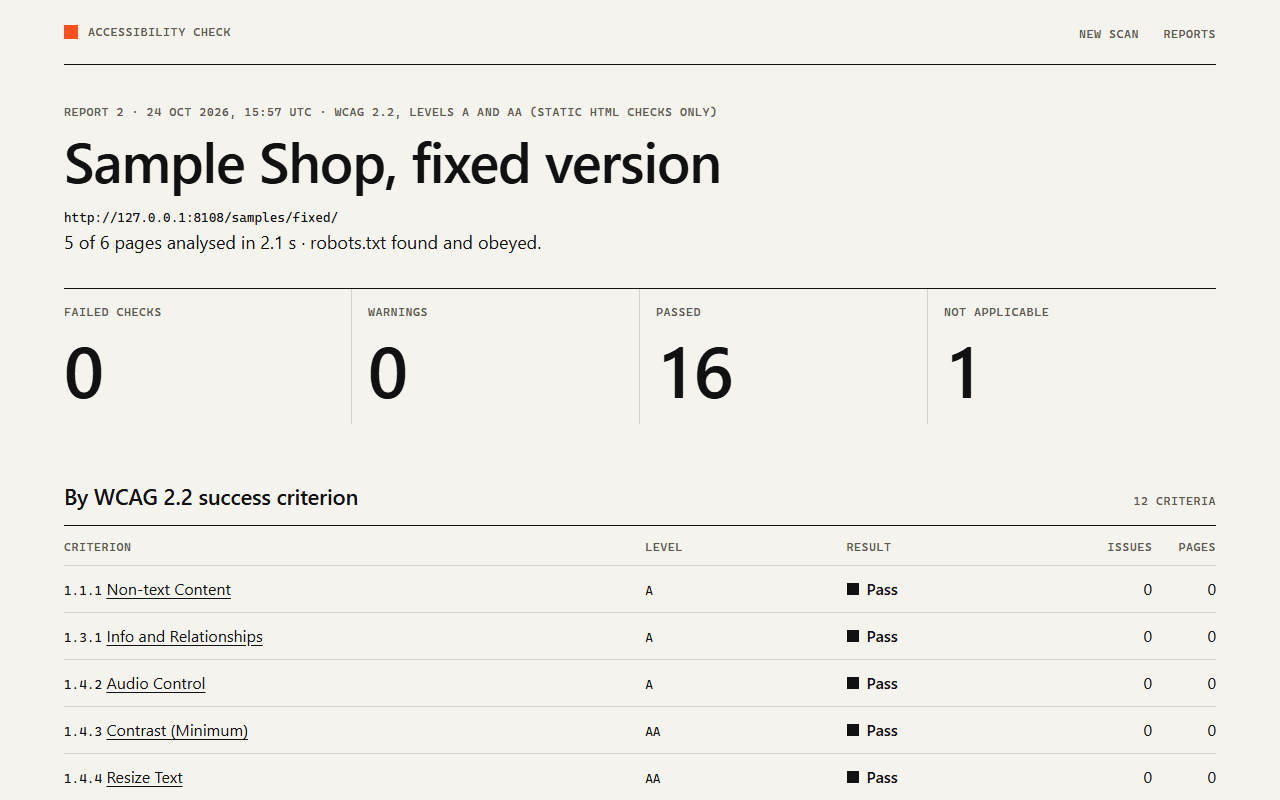
- Der Bericht zeigt das Ergebnis nach Kriterium, nach Regel und nach Seite und lässt sich als eine HTML-Datei oder als JSON herunterladen. Berichte werden in SQLite gespeichert.
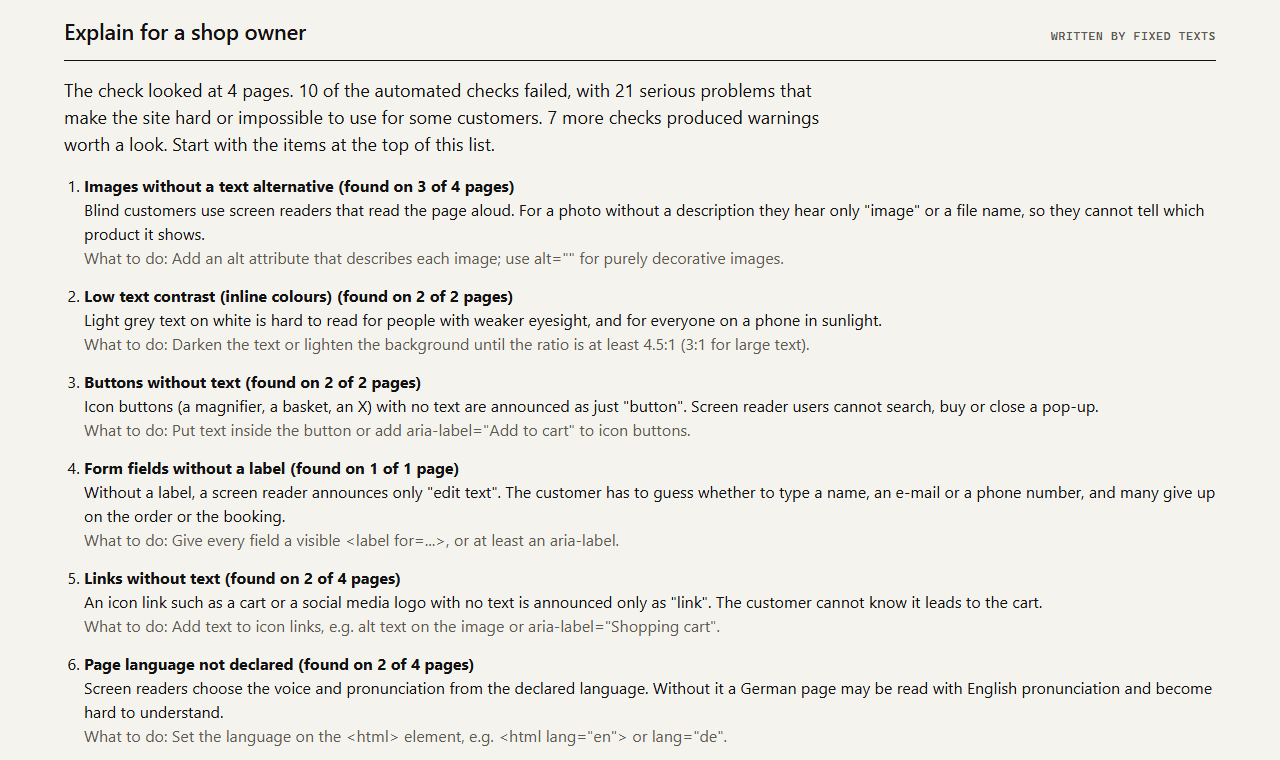
- „Explain for a shop owner“ schreibt eine Zusammenfassung in einfachen Worten: offline aus festen Texten oder mit Claude auf Englisch, Deutsch, Russisch oder Türkisch.
- Der Bericht sagt klar, was er nicht prüfen kann: dargestellte Farben, Tastaturbedienung, Fokusreihenfolge und das tatsächliche Verhalten von Screenreadern brauchen weiterhin manuelle Tests.
Screenshots
Technologien
- Python 3.12
- asyncio
- httpx
- FastAPI
- Jinja2
- BeautifulSoup
- lxml
- SQLite
- Anthropic API
- pytest
- Docker
Der Crawler nutzt httpx und asyncio mit zwei Workern, einem Seitenlimit und einer Pause nach
jeder Anfrage. robots.txt liest mein eigener Parser nach RFC 9309, weil der in Python eingebaute
die erste passende Zeile statt der längsten anwendet und den Platzhalter * nicht kennt. Das HTML
wird mit BeautifulSoup und lxml geparst. Adressen, die in private Netze führen, werden abgelehnt,
damit eine öffentliche Instanz des Werkzeugs nicht das Netz des eigenen Servers abtasten kann.
Code im Detail
Die Kontrastprüfung verwendet direkt die Formeln aus WCAG 2.2. #777 auf Weiß ergibt 4.48:1,
knapp unter den 4.5:1, die Text in normaler Größe braucht:
def _channel(value_8bit: int) -> float:
    c = value_8bit / 255
    return c / 12.92 if c <= 0.04045 else ((c + 0.055) / 1.055) ** 2.4


def relative_luminance(color: RGBA) -> float:
    return 0.2126 * _channel(color.r) + 0.7152 * _channel(color.g) + 0.0722 * _channel(color.b)


def contrast_ratio(a: RGBA, b: RGBA) -> float:
    la, lb = relative_luminance(a), relative_luminance(b)
    lighter, darker = max(la, lb), min(la, lb)
    return (lighter + 0.05) / (darker + 0.05)
Ein Fehler, den ich gefunden und behoben habe
Die Startseite wurde doppelt analysiert, ihre Probleme also doppelt gezählt
Was kaputt war
Der erste Scan meines fehlerhaften Beispielshops meldete den gesperrten Zoom auf „2 Seiten“ und ein Sprachproblem auf 3 Seiten. Den Zoom-Fehler hatte ich nur auf der Startseite eingebaut, den Sprachfehler auf zwei Seiten – die Zahlen stimmten also nicht.
Ursache
Der Scan beginnt bei /samples/broken/, und das Menü verlinkt auf index.html. Der Server liefert
für beide Adressen dasselbe Dokument. Allein aus den URLs kann der Crawler nicht erkennen, dass es
dieselbe Seite ist. Deshalb hat er die Startseite zweimal analysiert und jedes ihrer Probleme
doppelt gezählt.
Die Lösung
Der Crawler bildet jetzt einen Hash über das HTML jeder Seite. Eine Seite mit genau demselben HTML wie eine bereits analysierte bleibt mit ihrem Statuscode in der Liste, wird als Duplikat markiert und weder erneut analysiert noch weiterverfolgt. Derselbe Scan zeigt jetzt 4 analysierte Seiten und die richtigen Zahlen, und ein Test legt die genaue Anzahl der Befunde für jede Regel fest.
if page.final_url != page.url and page.final_url in self._final_urls:
    page.error = page.error or f"Redirects to {page.final_url}, which is already scanned"
    page.soup = None
self._final_urls.add(page.final_url)if page.final_url != page.url and page.final_url in self._final_urls:
page.duplicate_of = self._final_urls[page.final_url]
elif page.body_hash and page.body_hash in self._hashes:
page.duplicate_of = self._hashes[page.body_hash]
if page.duplicate_of:
page.soup = None # same document: do not analyse it or follow its links again
else:
self._final_urls.setdefault(page.final_url, page.url)
if page.body_hash:
self._hashes[page.body_hash] = page.urlErgebnis
- 208 automatisierte Tests (110 Testfunktionen): jede Regel mit bestehendem und nicht bestehendem HTML, die Kontrastberechnung mit bekannten Werten und der Crawler gegen nachgebaute Websites (robots.txt, Seitenlimit, Weiterleitungen, Parallelität).
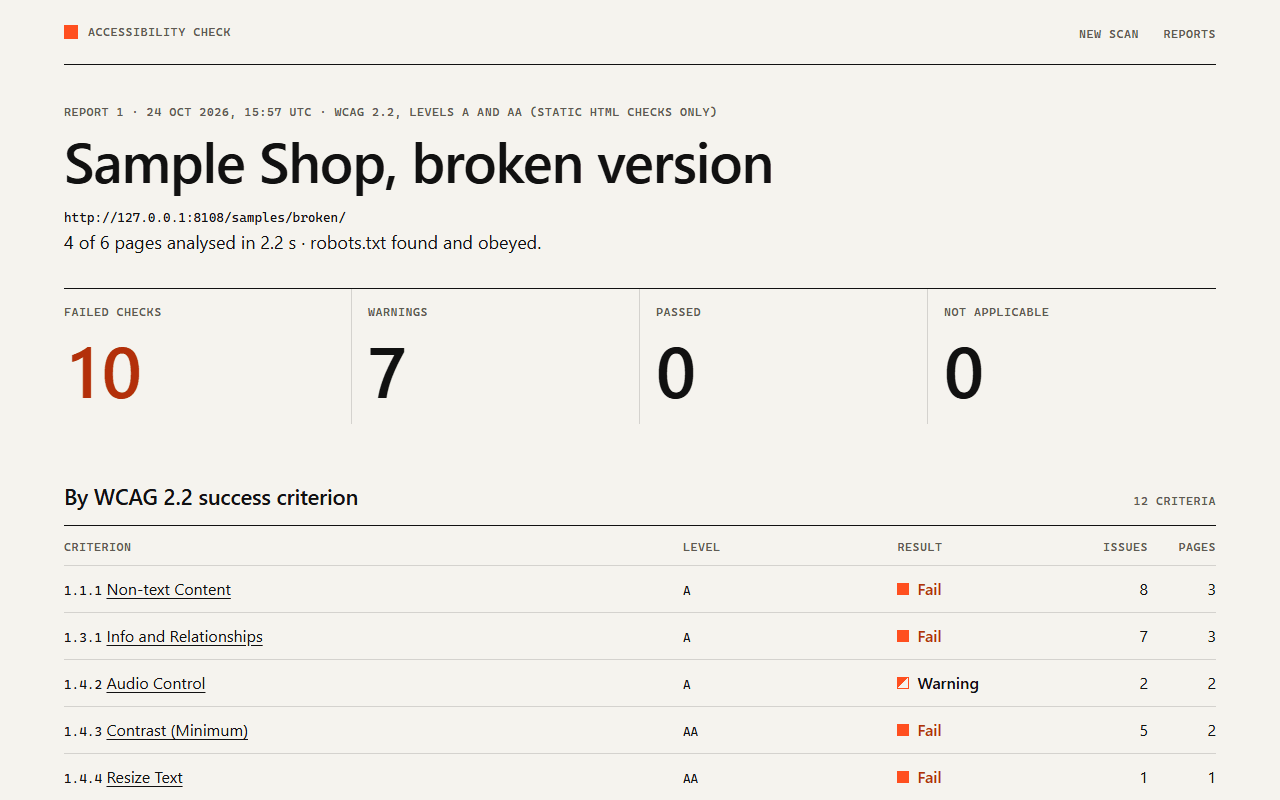
- Der fehlerhafte Beispielshop: 10 nicht bestandene Prüfungen und 7 Warnungen auf 4 Seiten. Die korrigierte Version: 16 Prüfungen bestanden, 0 nicht bestanden. Jeder Scan dauert mit den höflichen Pausen etwa 2 Sekunden.
- Ein echter Scan meiner eigenen Portfolio-Website: 15 Seiten in 7,5 Sekunden, 0 nicht bestandene Prüfungen, 13 bestanden, 4 nicht anwendbar (keine Formulare, keine Farben im HTML, keine Frames).