E-Invoice
Превращает PDF-счёт в электронный счёт XRechnung и по правилам объясняет, что в нём не так.
- Роль
- Личный проект — проектирование, код, тесты
- Год
- 2026
- Категория
- ИИ · Веб
- Стек
- Python 3.12, FastAPI, Jinja2, Anthropic API
Проблема
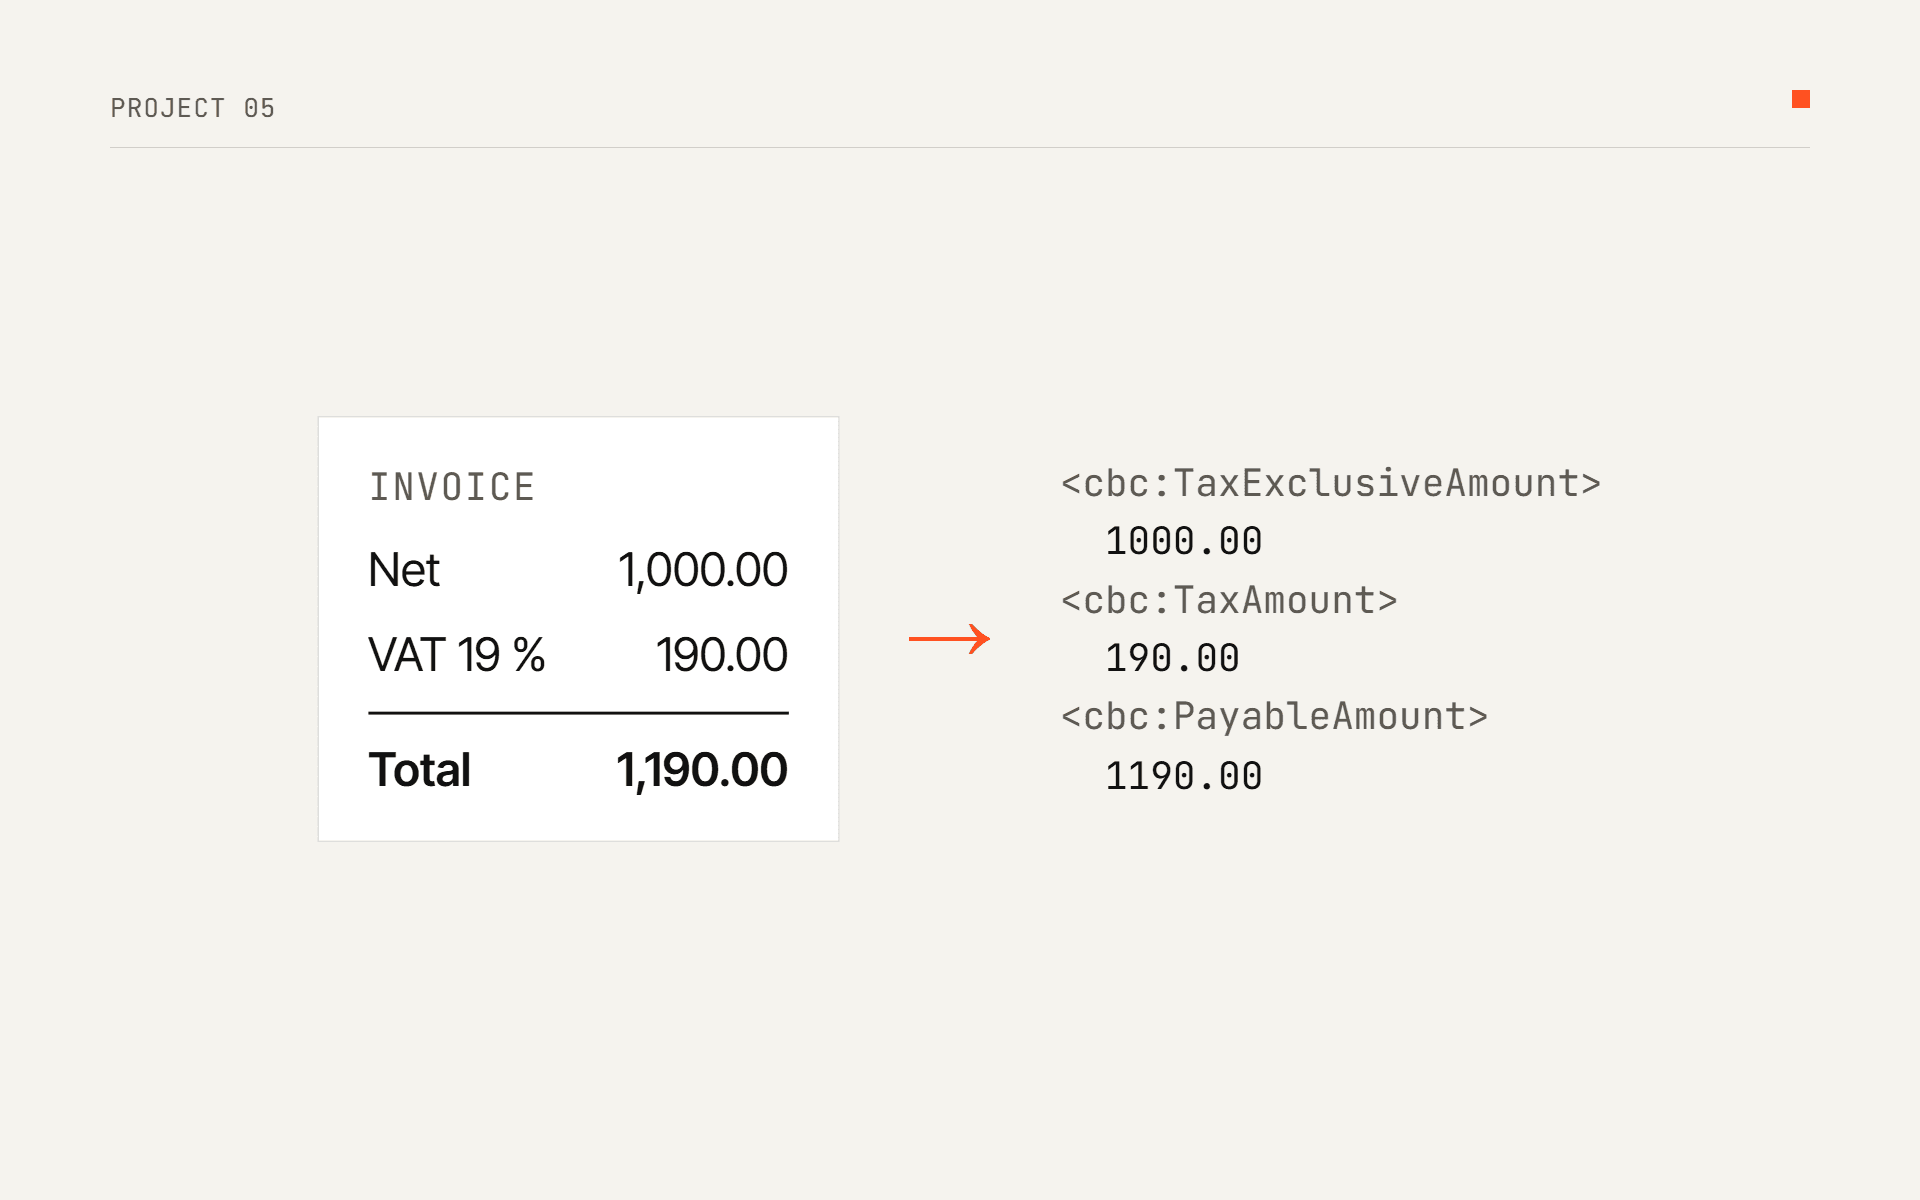
С 1 января 2025 года счета между компаниями в Германии должны быть электронными: в структурированном формате по европейскому стандарту EN 16931, а не в PDF. Бумага и PDF ещё разрешены до 31 декабря 2026 года, а для компаний с оборотом за прошлый год не более 800 000 евро — до 31 декабря 2027 года. Для приёма переходного периода нет: с 1 января 2025 года каждая компания должна уметь принимать электронные счета.
Многие небольшие компании до сих пор пишут счета в Word и отправляют PDF. PDF может выглядеть правильно для человека и всё равно быть неверным для машины: суммы не сходятся, нет ссылки покупателя, в IBAN опечатка. Я хочу работать в Европе, а в Германии через это изменение прямо сейчас проходит каждая компания, поэтому я сделал конвертер, которым сам хотел бы пользоваться на месте бухгалтера.
Решение
- Текстовый слой PDF собирается обратно в строки и ячейки таблицы по координатам слов, поэтому строка таблицы остаётся строкой.
- Claude читает счёт в заранее заданную JSON-схему (structured output). Ему сказано копировать то, что напечатано, и не исправлять числа: «исправленная» сумма спрятала бы ту самую ошибку, ради которой нужен валидатор.
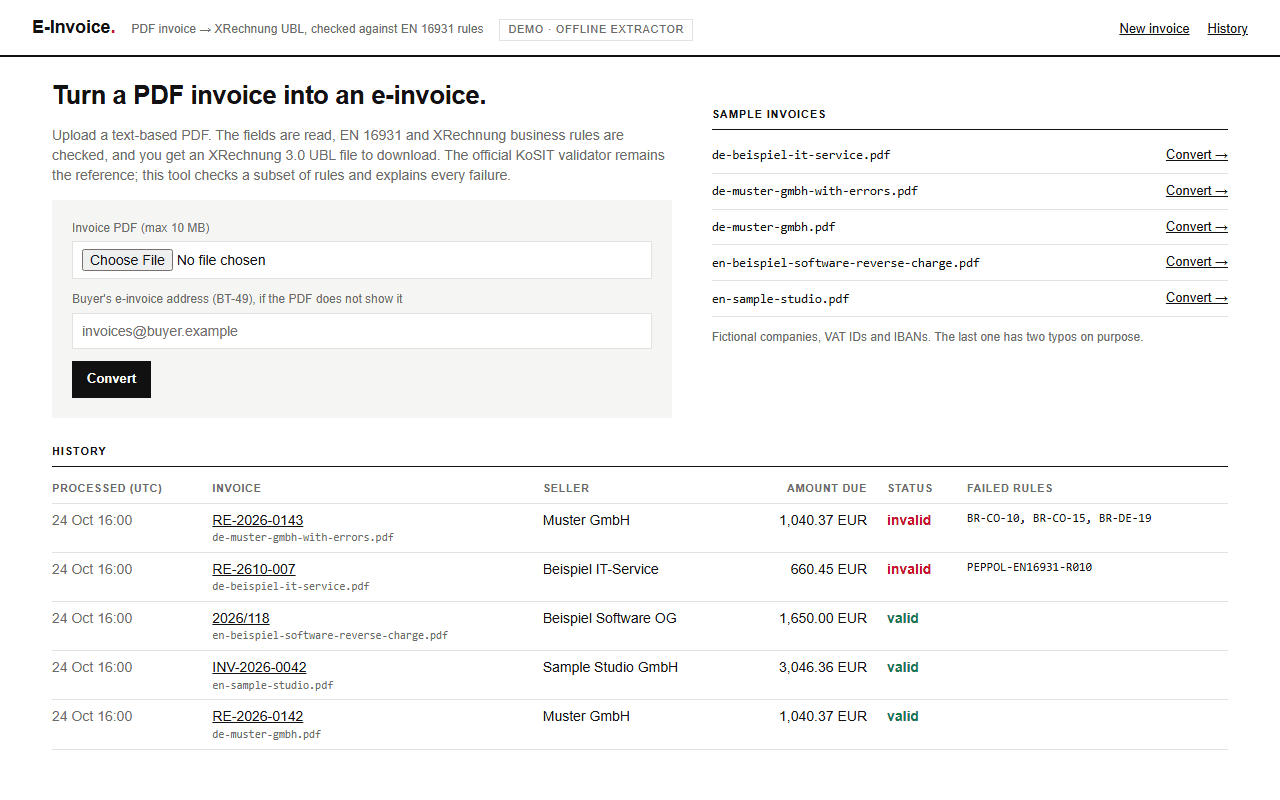
- Без API-ключа экстрактор на правилах читает встроенные немецкие и английские макеты офлайн (демо-режим).
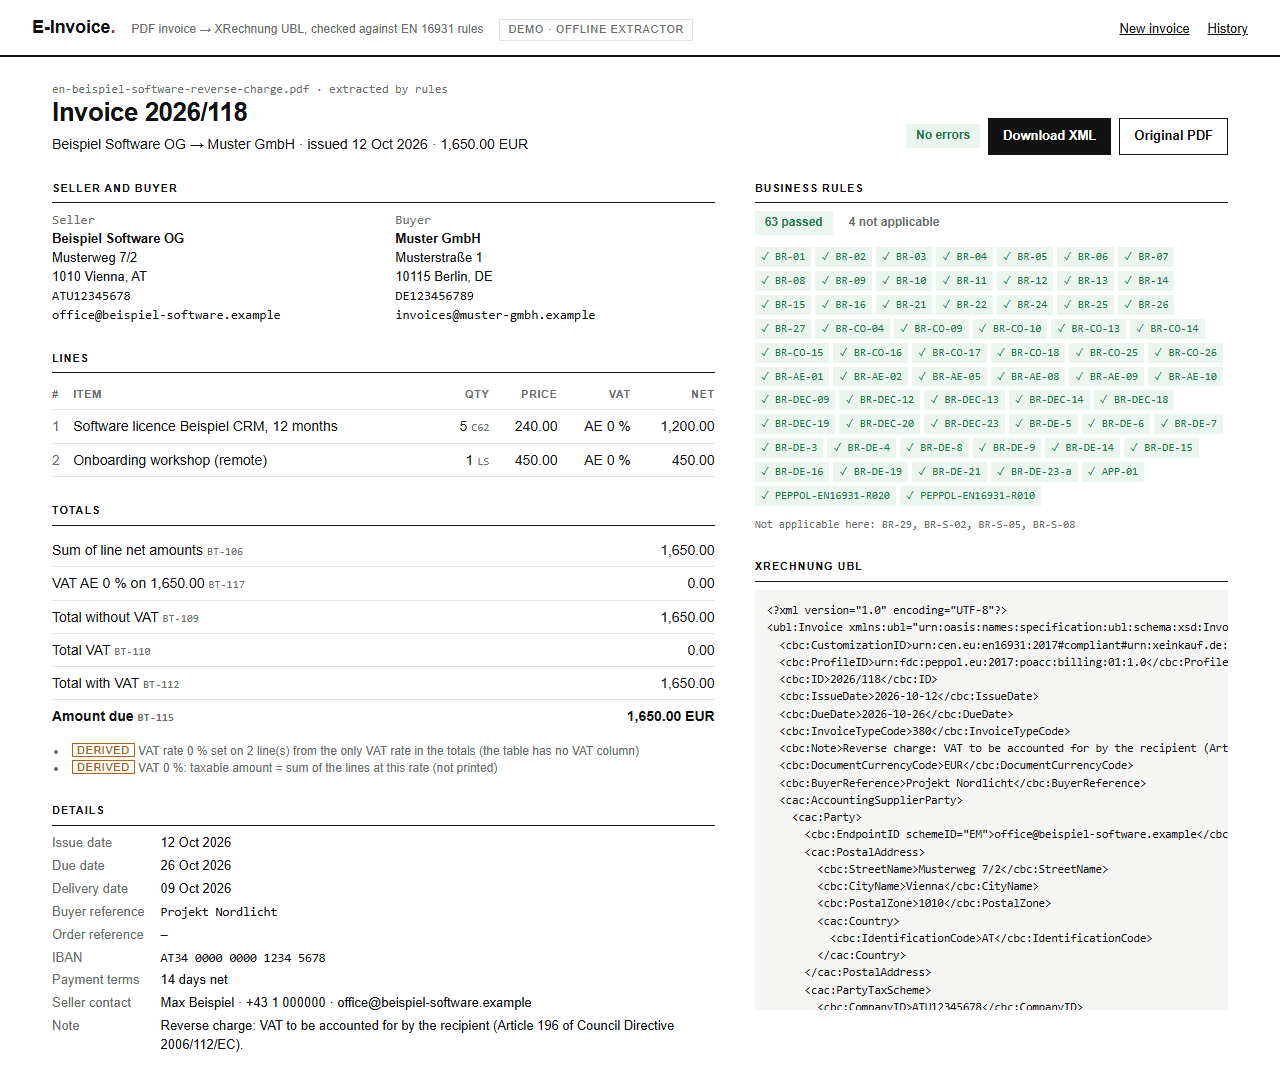
- Значения, которых нет в PDF, но которые нужны стандарту, вычисляются и помечаются как derived, чтобы «вычислено» никогда не путалось с «проверено».
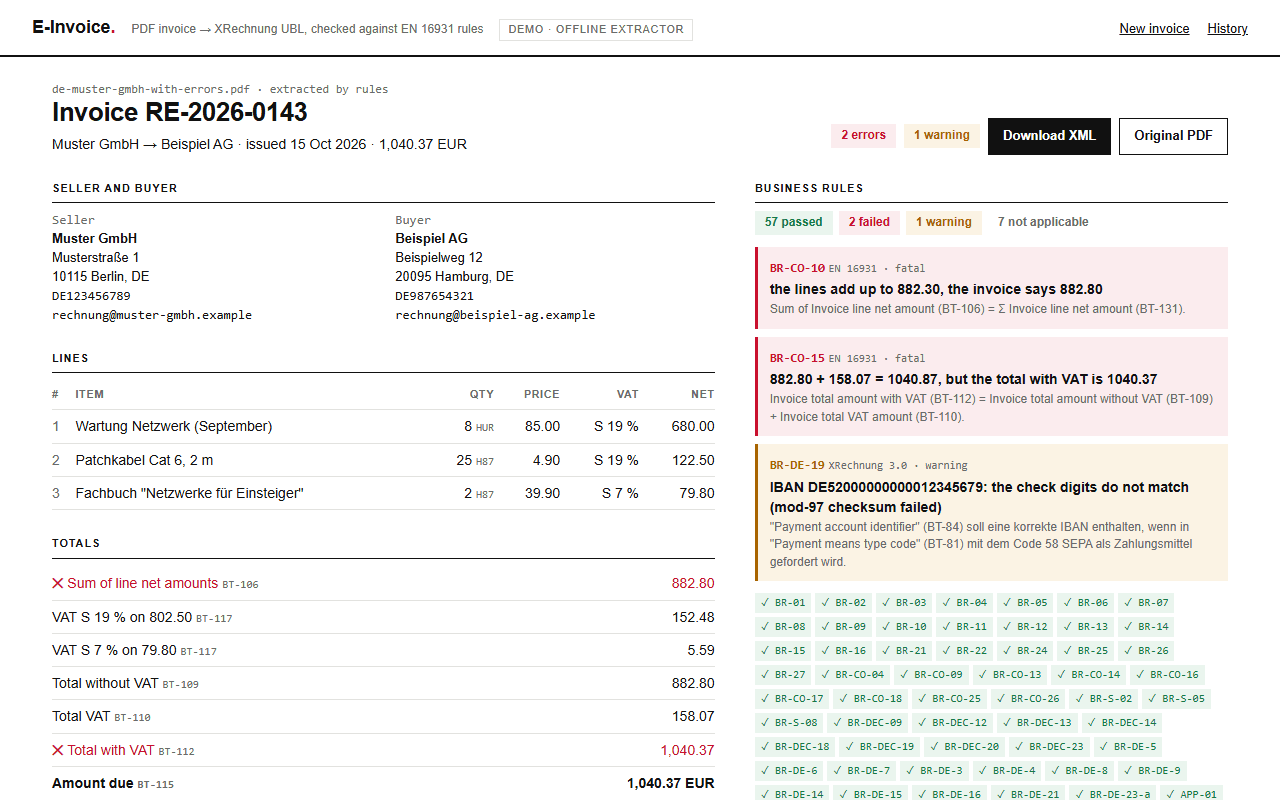
- 67 бизнес-правил с официальными ID: 51 из EN 16931, 15 из XRechnung и 1 моё собственное. Каждое нарушенное правило показывает свой ID и числа: «BR-CO-10: the lines add up to 882.30, the invoice says 882.80».
- На выходе — файл XRechnung 3.0 UBL 2.1 для скачивания, из веб-приложения или из командной строки. История в SQLite хранит каждый счёт, его статус и его XML.
Скриншоты
Технологии
- Python 3.12
- FastAPI
- Jinja2
- Anthropic API
- pdfplumber
- lxml
- SQLite
- pytest
Деньги везде хранятся в Decimal и округляются половиной вверх, как XPath-функция round() в
официальных правилах; встроенный round() в Python округляет 0,125 до 0,12. JSON-схема для LLM
возвращает суммы строками, поэтому они никогда не проходят через float. Эталон — официальный
валидатор KoSIT (на Java); чтобы понять, насколько близко моё подмножество правил, скрипт прогоняет
на XML каждого примера официальную схему UBL, схематронику CEN EN 16931 и схематронику KoSIT
XRechnung.
Фрагмент кода
Каждое правило — маленькая функция, зарегистрированная со своим официальным ID и текстом. Она
возвращает None, если счёт проходит проверку, или фразу с настоящими числами, если не проходит.
Тест намеренно ломает каждое правило, а ещё один тест падает, если у нового правила такого случая
нет:
@rule(
    "BR-CO-15",
    "Invoice total amount with VAT (BT-112) = Invoice total amount without VAT (BT-109) + "
    "Invoice total VAT amount (BT-110).",
)
def br_co_15(inv: Invoice) -> str | None:
    t = inv.totals
    if t.tax_inclusive is None or t.tax_exclusive is None or t.vat_total is None:
        raise NotApplicable
    expected = _xpath_round(t.tax_exclusive + t.vat_total)
    if t.tax_inclusive == expected:
        return None
    return (
        f"{t.tax_exclusive:f} + {t.vat_total:f} = {expected:f}, "
        f"but the total with VAT is {t.tax_inclusive:f}"
    )
Баг, который я нашёл и исправил
Моё правило BR-CO-13 находило ошибку, которой нет в официальных правилах
Что сломалось
Для примера с неверной промежуточной суммой (строки дают 882,30, в PDF написано 882,80) мой валидатор показывал три ошибки. Официальная схематроника CEN на том же XML показала две: BR-CO-10 и BR-CO-15, но не BR-CO-13.
Причина
Я реализовал BR-CO-13 по тексту правила: «сумма без НДС = Σ нетто-сумм строк − скидки + надбавки». Официальная проверка строки не суммирует. Без скидок и надбавок она сравнивает сумму без НДС (BT-109) с напечатанной в счёте суммой по строкам (BT-106). Сверять строки с BT-106 — задача BR-CO-10, поэтому одна опечатка попадала в отчёт дважды, и мой отчёт не совпадал с тем, что покажет валидатор у покупателя.
Исправление
Теперь я следую проверке из схематроники, а регрессионный тест следит, чтобы так и оставалось. С тех пор я читаю официальную проверку каждого арифметического правила, а не только его однострочный текст. На всех пяти примерах мой валидатор и официальная схематроника теперь выдают ровно одинаковые ID правил.
expected = _xpath_round(_sum(line.net_amount for line in inv.lines))
if inv.totals.tax_exclusive == expected:
return None# The official schematron compares BT-109 with BT-106 (LineExtensionAmount), not with the
# sum of the lines: that sum is BR-CO-10's job.
if t.tax_exclusive == t.line_net_total:
return NoneРезультат
- 192 автоматических теста: извлечение на каждом макете-примере, каждое из 67 правил — и прохождение, и нарушение, округление
Decimal, XML, разобранный обратно поэлементно, веб-приложение и командная строка. - На всех пяти примерах официальная схематроника CEN и KoSIT выдаёт ровно те же ID правил, что и мой валидатор, а каждый XML-файл проходит проверку схемой UBL 2.1.
- Офлайн-конвертация одного примера (чтение, извлечение, 67 правил, XML) занимает 16–29 мс.